FlowNex 技术文档
Date: 2026-07-27

1. 产品概览
1.1 FlowNex 是什么
FlowNex 是行云面向企业级 AI-Agent 场景自研的能力中台。它不是单一的聊天机器人,也不是只面向代码开发的垂直 Agent,而是一套用于构建、运行、治理和持续演进企业 Agent 能力的基础平台。
FlowNex 以对话和任务为入口,以 share-harness 为运行时执行底座,以 Skill、Tool、知识库、AGFS、多 Agent 任务图为核心能力组件,为企业内部业务团队提供可配置、可授权、可观测、可复用的 AI-Agent 能力。
在产品形态上,FlowNex 同时包含:
- 面向最终用户的 Agent 对话与任务执行入口。
- 面向管理员的 Skill、知识库、权限、模型和运行时配置管理。
- 面向开发者的 Tool、Skill、Runtime、AGFS 和知识检索扩展能力。
- 面向运营和治理团队的任务轨迹、知识命中、文件产物、用户反馈和审计回放能力。
它要解决的核心问题是:
一个组织如何规模化生产、运行、管理和优化 AI-Agent 能力。
1.2 产品定位:行云 AI-Agent 自研能力中台
FlowNex 的产品定位是:
行云 AI-Agent 自研能力中台。
这里的“能力中台”包含三层含义。
第一,FlowNex 是 Agent 能力的生产平台。
业务团队可以在平台中创建和管理 Skill,绑定知识库,配置可用工具,选择模型能力,并将这些能力组合成面向具体场景的 Agent 能力包。例如合同评审助手、项目交付助手、数据分析助手、售前方案助手、知识运营助手等。
第二,FlowNex 是 Agent 能力的运行平台。
用户发起对话、管理台操作、Skill 配置、知识库管理、任务中心等 FlowNex 主站交互时,请求仍然经过 ai-claw-gateway,再进入后端控制与运行时链路。ai-claw-gateway 没有下线,它负责 FlowNex 初始 AI 应用入口之外的所有产品交互。
AI 应用中心内的 AI 应用请求则走另一条专用链路:请求经过 ai-app-runtime-gateway 的 application 前缀路由进入 AI 应用接入层,再由 ai-app-service 承接前端 AI 应用所需的应用层交互接口、业务语义接口和业务数据落库。这里的 AI 应用包括行云 AI 算力专项学习服务、会议智能总结、智能项目管理、智能标书等业务应用。
当 AI 应用中心的前端应用需要请求原子 AI 能力时,请求先经过 ai-app-runtime-gateway 和 ai-app-service,再进入 control-center 能力中心;当现有 Web 前端、飞书、钉钉或 Agent 运行时需要请求原子 AI 能力时,仍沿用 ai-claw-gateway -> control-center 或运行时内部链路,由 control-center 能力中心完成能力授权、路由、调用治理和 Provider 适配。
其中 Capability Gateway 和 Provider Adapter 不是独立部署的应用,而是 control-center 内部的能力中心实现类或模块。运行时会根据当前用户、租户、角色、Skill、Tool、知识库范围和文件上下文,动态装配本轮 Agent 所需能力,并通过 SSE 将执行过程和结果回推给客户端。
第三,FlowNex 是 Agent 能力的治理平台。
平台需要知道一次任务为什么这样回答,调用了哪些工具,使用了哪些知识,读取或生成了哪些文件,哪些步骤失败,哪些产物可以沉淀为知识,哪些 badcase 可以进入经验演进。这些能力决定了 FlowNex 与普通 2C Agent 产品的根本区别。
FlowNex 的中台目标可以概括为:
Agent 能力可配置
Agent 执行可追踪
Agent 上下文可治理
Agent 文件可回滚
Agent 经验可沉淀
Agent 能力可演进
1.3 FlowNex 的三层能力体系
接入方案上线后,FlowNex 的能力边界需要从“自研 Agent 能力中台”进一步扩展为“企业 AI 应用与原子化 AI 能力的统一接入、编排、治理与运营中台”。
新的能力体系可以拆成三层:
| 层级 | 面向对象 | 主要职责 |
|---|---|---|
| AI 应用层 | 业务用户、业务系统、业务线产品 | 承接完整业务场景,例如请假助手、报销助手、数据分析助手、合同审核助手、业务线自建 AI 应用 |
| Agent 编排层 | FlowNex Runtime、多 Agent、Skill | 理解任务、选择能力、装配上下文、编排步骤、调用工具、沉淀结果 |
| 原子能力层 | 业务线系统、AI 服务 Provider、内部平台能力 | 提供可复用的最小能力单元,例如 OCR、审批查询、订单创建、报表分析、合同审核、知识检索 |
这三层不是互相替代关系,而是逐层抽象:
- AI 应用层负责面向业务表达“用户要完成什么场景”。
- Agent 编排层负责把场景拆成任务、步骤、上下文和能力调用。
- 原子能力层负责提供稳定、可治理、可复用的底层动作或智能能力。
因此,FlowNex 后续需要新增一类基础能力:
面向不同业务线 AI 应用接入 FlowNex,以及原子化 AI 能力统一注册、授权、路由、调用、观测和运营的能力管理底座。
这意味着 FlowNex 不只管理自己创建的 Skill 和 Agent,也要能接入集团内其他业务线已有的 AI 能力,把它们包装成统一的 Capability、Tool 或 Skill,并纳入租户、角色、审计、Trace、质量评估和成本统计。
1.4 核心能力总览
FlowNex 的核心能力可以分为八类。

1. Agent 对话与任务执行
FlowNex 支持用户通过 Web、飞书 / Lark 等渠道发起 Agent 对话和任务。
每次用户输入会被建模为一次可追踪任务,任务中可以包含:
- 用户消息。
- 用户上传文件。
- 本轮授权的 Tool。
- 本轮授权的 Skill。
- 知识库选择范围。
- 运行时产生的任务步骤。
- Agent 输出的最终结果和文件产物。
相比普通聊天机器人,FlowNex 更强调任务过程和执行证据,而不是只保存最终回复。
2. Skill 能力体系
Skill 是 FlowNex 中可复用的 Agent 专业能力单元。
一个 Skill 可以描述某类任务的执行方法、输入约束、输出格式、工具使用方式、知识依赖和风险边界。例如:
- 合同评审 Skill。
- 周报生成 Skill。
- 数据分析报告 Skill。
- 飞书审批处理 Skill。
- 项目复盘总结 Skill。
FlowNex 支持 Skill 的创建、审核、发布、安装、预装、启停和运行时授权。后续 Skill 还会进一步与知识库、AGFS 文件产物、任务轨迹和经验演进闭环打通。
3. Tool 执行体系
Tool 是 Agent 可以调用的外部能力。
Tool 可以包括:
- 文件读写。
- Shell 执行。
- Web 搜索。
- 飞书 / Lark API。
- 业务系统 API。
- 数据库或内部服务查询。
- AGFS 文件操作。
在 FlowNex 中,Tool 不只是模型可见的函数列表,还要纳入权限、审计、运行时隔离和失败回放。外部工具通过 toolCodes 授权,运行时内置文件能力则由 share-harness 的执行策略控制。
4. 知识库系统
FlowNex 接入 OpenViking 知识库作为组织知识检索底座。
知识库主要承载:
- 企业制度。
- SOP。
- 业务说明文档。
- 项目资料。
- 会议纪要。
- FAQ。
- 角色共享模板。
- 可复用案例。
OpenViking 负责知识检索能力,FlowNex 负责本地知识映射、租户和角色可见范围、用户授权范围计算、运行时知识范围装配、引用追踪和降级策略。
知识库在 FlowNex 中不是一个孤立搜索入口,而是 Agent 能力的重要上下文来源。
5. Skill 与知识库绑定
Skill 负责“怎么做事”,知识库负责“依据什么做事”。因此,业务型 Skill 需要能够绑定默认知识范围。
例如:
- 合同评审 Skill 绑定合同模板、法务审查规则和风险条款库。
- 项目交付 Skill 绑定项目 SOP、交付模板和历史复盘。
- 售前方案 Skill 绑定产品能力说明、报价规则和客户案例。
绑定关系可以降低检索噪声,提升 Skill 输出稳定性,并帮助平台判断任务失败原因来自 Skill 本身、知识缺失、知识过期还是召回质量。
第一阶段,FlowNex 建议采用轻量绑定:
- 工具型 Skill 默认不绑定知识。
- 方法型 Skill 可选绑定知识。
- 业务型 Skill 推荐绑定知识。
- 高风险 Skill 支持
REQUIRED强绑定。
6. AGFS 文件系统
AGFS 是 FlowNex 后续自建的 Agent Graph File System。
它的目标不是替代普通 OSS 附件管理,而是成为 Agent 运行时文件世界的基础设施。
AGFS 负责:
- Agent workspace。
- 任务产物文件。
- 多 Agent 共享文件。
- 文件版本历史。
- 任务 checkpoint。
- 文件系统级快照与回滚。
- 文件血缘追踪。
- 高价值文件沉淀为知识候选。
在 AGFS 中,Agent、Shell、MCP、FUSE 和 HTTP File API 应看到同一套文件树。一个 Agent 生成的文件,可以被另一个 Agent 立即读取;一次错误的脚本执行,也可以通过 checkpoint 回滚。
AGFS 与 OpenViking 的边界是:
- OpenViking 管组织知识和 RAG 检索。
- AGFS 管运行时文件、协作工作区、版本和回滚。
7. 多 Agent 协作框架
FlowNex 后续会从单 Agent 执行升级为多 Agent 协作。
多 Agent 协作不是简单让多个模型并发回答,而是围绕任务图、共享知识和 AGFS 工作区进行受控协作。
建议的基础角色包括:
Planner:负责拆解任务和制定执行计划。Researcher:负责检索知识和收集资料。Executor:负责调用工具和产出文件。Reviewer:负责检查结果、发现遗漏和风险。Synthesizer:负责汇总最终输出。
多 Agent 协作的关键底座是 AGFS。所有 Agent 围绕同一个 project space 或 task space 工作,任务产物、审阅意见、中间数据和最终报告都可以被统一追踪和回滚。
8. 观测、审计与演进闭环
企业级 Agent 平台必须回答“为什么”。
FlowNex 需要观测:
- 本轮选择了哪些 Skill。
- 本轮授权了哪些 Tool。
- 本轮检索了哪些知识库。
- 最终引用了哪些知识片段。
- 哪些知识因权限被裁掉。
- Agent 生成或修改了哪些文件。
- 多 Agent 各自完成了哪些子任务。
- 用户是否点赞、点踩或追问。
这些轨迹不仅用于排障和审计,也会成为后续经验沉淀的输入。高质量任务结果可以沉淀为知识库草稿,高频 badcase 可以沉淀为 runtime reminder、Skill 附录或评测集。
1.5 与 Codex / OpenClaw / 通用 Agent 产品的区别
FlowNex 与 Codex、OpenClaw 这类 Agent 产品的区别,主要不在模型能力,而在产品对象和平台边界。
1. 与 Codex 的区别
Codex 更偏向软件工程 Agent。它的核心场景是代码理解、代码修改、测试运行、工程任务处理和开发者工作流提效。
FlowNex 的目标不是只做编码 Agent,而是面向企业业务场景构建 Agent 能力中台。
主要区别:
| 维度 | FlowNex | Codex |
|---|---|---|
| 核心定位 | 企业 Agent 能力中台 | 软件工程 Agent |
| 核心上下文 | 组织知识、业务流程、Skill、文件、任务轨迹 | 代码仓库、Issue、测试、工程上下文 |
| 用户对象 | 企业业务团队、管理员、内部员工、开发者 | 开发者、工程团队 |
| 治理重点 | 租户、角色、知识、Skill、Tool、文件、审计 | 仓库权限、代码变更、测试和 PR |
| 协作方向 | 多人多 Agent 业务协作 | 开发者与编码 Agent 协作 |
可以概括为:
Codex 是 AI 程序员,FlowNex 是企业 Agent 能力中台。
2. 与 OpenClaw 的区别
OpenClaw 更偏向 2C 或 prosumer 场景,是面向个人的本地常驻 AI 助手。它强调个人设备、本地运行、聊天入口和自托管可控性。
FlowNex 面向企业组织,更强调租户隔离、权限治理、知识授权、多 Agent 协作、文件审计和能力运营。
主要区别:
| 维度 | FlowNex | OpenClaw |
|---|---|---|
| 核心定位 | 企业 Agent 能力中台 | 个人 AI 助手 / 本地 Agent |
| 核心用户 | 企业组织和内部业务团队 | 个人用户、极客、自托管用户 |
| 文件系统 | AGFS 项目空间、多 Agent 共享、快照回滚、审计 | 个人本地文件和个人上下文 |
| 权限体系 | 租户、部门、角色、项目、个人多层权限 | 个人设备权限为主 |
| 产品目标 | 组织规模化生产和治理 Agent 能力 | 个人拥有可控的 AI 助手 |
可以概括为:
OpenClaw 是个人 AI 助手,FlowNex 是组织级 Agent 基础设施。
3. 与通用聊天 Agent 的区别
通用聊天 Agent 通常关注自然语言交互和模型回答质量,但企业场景还需要更多平台能力。
FlowNex 关注:
- 任务是否可追踪。
- 知识是否可授权。
- Skill 是否可复用。
- Tool 是否可审计。
- 文件是否可回滚。
- 产物是否可沉淀。
- 多 Agent 是否可协作。
- 能力是否可灰度、评测和运营。
这使得 FlowNex 更接近企业级 Agent 操作系统,而不是单一聊天产品。
1.6 典型使用场景
FlowNex 面向企业内部多类业务场景。
1. 企业知识问答
用户可以基于授权知识库提问,例如:
- 查询公司制度。
- 查询业务 SOP。
- 查询产品能力说明。
- 查询项目资料。
- 查询 FAQ 和历史案例。
系统会根据用户身份、租户、角色和知识库可见范围裁剪可检索知识,并在回答中返回引用依据。
2. 业务文档生成
用户可以通过 Skill 生成结构化文档,例如:
- 周报。
- 月报。
- 项目复盘。
- 会议纪要。
- 售前方案。
- 合同审查意见。
这类任务通常会使用 Skill 约束输出结构,同时结合知识库中的模板、规则和案例。
3. 数据分析与报告
用户上传表格或数据文件后,Agent 可以完成:
- 数据清洗。
- 指标计算。
- 图表生成。
- 异常发现。
- 分析报告生成。
后续 AGFS 接入后,数据文件、中间结果、图表和最终报告都可以进入可追踪文件空间。
4. 项目交付助手
项目团队可以为每个项目配置知识范围和 AGFS 项目空间。
Agent 可以辅助:
- 汇总项目背景。
- 生成需求说明。
- 编写技术方案。
- 维护交付清单。
- 生成周报和复盘。
- 查询历史决策。
多 Agent 框架成熟后,可以由 Planner 拆任务,Researcher 查资料,Executor 生成文档,Reviewer 做审查,Synthesizer 汇总交付。
5. 飞书 / Lark 办公自动化
FlowNex 可接入飞书 / Lark 渠道,支持:
- 群聊或单聊触发 Agent。
- 读取飞书附件。
- 处理审批、日历、任务、文档等业务。
- 定时任务和提醒。
- 将执行结果回推到聊天窗口。
6. 企业 Agent 能力运营
管理员可以运营企业内部 Agent 能力:
- 创建 Skill。
- 审核 Skill。
- 配置 Skill 绑定知识。
- 预装 Skill 给部门或角色。
- 查看 Skill 使用率和成功率。
- 查看知识命中情况。
- 从任务结果中沉淀知识和经验。
1.7 系统边界与非目标
为了保证系统边界清晰,FlowNex 需要明确哪些事情当前做,哪些事情不做。
1. 当前核心范围
FlowNex 当前和未来半年重点覆盖:
- Agent 对话和任务执行。
- Skill 管理和运行时注入。
- Tool 授权和调用。
- OpenViking 组织知识库接入。
- Skill 与知识库绑定。
- AGFS 自建运行时文件系统。
- 多 Agent 协作框架。
- 任务轨迹、知识命中、文件产物和用户反馈观测。
- 经验沉淀和能力演进闭环。
- 业务线 AI 应用和原子化 AI 能力的接入、授权、调用、观测和运营。
2. 当前非目标
FlowNex 不应在当前阶段承担以下目标:
- 不做通用 2C 个人 AI 助手。
- 不做只面向编码场景的垂直工程 Agent。
- 不把运行时文件托管给 OpenViking Service。
- 不自研替代 OpenViking 的组织知识向量检索底座。
- 不让所有 Skill 强制绑定知识。
- 不让所有临时文件都进入 AGFS 云端主树。
- 不做无审计、无评测、无回滚的自动自我改写。
- 不让多 Agent 自由抢占同一个最终输出。
3. 长期演进边界
长期看,FlowNex 可以逐步增强以下能力:
- 更完整的 AGFS 文件权限。
- 更强的多 Agent 任务图调度。
- 更稳定的 Skill 评测和灰度发布。
- 更细粒度的知识命中质量评估。
- 更自动化的经验沉淀。
- 更丰富的企业系统连接器。
但这些能力都应围绕同一条主线展开:
帮助组织规模化生产、治理和运营 AI-Agent 能力。
2. 快速开始
2.1 快速体验一轮 Agent 对话
FlowNex 最基础的使用入口是一轮 Agent 对话。
用户在客户端输入自然语言问题后,系统会完成以下动作:
- FlowNex 主站对话、任务中心、Skill、知识库和管理台交互通过
ai-claw-gateway接入。 - AI 应用中心的应用请求通过
ai-app-runtime-gateway的application前缀路由接入,例如行云 AI 算力专项学习服务、会议智能总结、智能项目管理、智能标书。 - AI 应用请求进入
ai-app-service,由它承接应用层交互、应用会话、业务语义接口和业务数据落库。 - 当请求需要 Agent 执行或原子 AI 能力时,
ai-app-service对接control-center。 control-center根据当前用户、租户、角色和能力配置,计算本轮可用的 Capability、Tool、Skill 和知识库范围。agent-runtime-gateway将任务路由到可用的share-harness实例。share-harness重建本轮上下文,调用模型、工具和 Skill。- 执行过程通过 SSE 实时返回给用户。
- 任务完成后,消息、任务状态、任务步骤、文件产物和运行指标被持久化。
一次最简单的对话可以不显式选择 Skill 或知识库。例如:
用户:帮我总结一下 FlowNex 当前的系统架构。
Agent:根据当前系统模块,FlowNex 可以分为接入层、编排层、领域层、运行时层和公共能力层……
如果本轮没有指定知识库或 Skill,系统会按默认能力范围执行。默认范围由租户、用户、角色和系统配置共同决定。
2.2 创建并运行一个任务
在 FlowNex 中,用户的一轮输入不仅是一条消息,也会被建模为一个任务。
任务用于承载可追踪的执行过程,包括:
- 本轮用户输入。
- 本轮附件。
- 本轮授权 Tool。
- 本轮授权 Skill。
- 本轮知识库范围。
- Agent 执行步骤。
- 工具调用结果。
- 生成文件。
- 最终回复。
- 成功、失败、取消等终态。
任务的典型生命周期如下:
flowchart LR
    A["用户发起消息"] --> B["创建 Message"]
    B --> C["创建 Task"]
    C --> D["下发 Runtime"]
    D --> E["执行 Task Step"]
    E --> F["生成回复 / 文件"]
    F --> G["Runtime Finish Callback"]
    G --> H["更新 Task 和 Message 状态"]
任务可以是普通聊天任务,也可以是定时任务、渠道入站任务或后续多 Agent 子任务。
用户通常不需要感知底层任务模型,但任务模型对企业场景非常重要,因为它支撑了:
- 执行过程可回放。
- 失败原因可排查。
- 文件产物可追踪。
- 用户反馈可关联。
- 后续经验可沉淀。
2.3 使用 Skill 完成专业任务
Skill 是 FlowNex 中面向专业任务的能力单元。
当用户的问题命中某个专业场景时,系统可以通过 Skill 提供更稳定的执行策略。例如:
用户:帮我根据这份会议记录生成一份项目周报。
系统选择:weekly-report Skill
Agent 行为:读取会议记录 -> 提取进展、风险、下周计划 -> 按周报模板生成结果。
Skill 可以来自:
- 平台预置 Skill。
- 租户管理员发布的企业 Skill。
- 团队维护的业务 Skill。
- 用户个人创建或安装的 Skill。
Skill 的使用方式可以分为两类:
- 用户显式选择 Skill。
- 系统根据用户输入和可用 Skill 自动推荐或命中。
运行时不会把 Skill 当成必须执行列表,而是把 Skill 作为本轮可用能力和上下文来源。最终是否使用某个 Skill,由 share-harness 根据用户意图、Skill 描述、任务证据和运行策略决定。
一个高质量 Skill 通常包括:
- 适用场景。
- 输入要求。
- 执行步骤。
- 输出格式。
- 可用工具。
- 依赖知识。
- 风险边界。
- 示例和反例。
2.4 使用知识库增强回答
知识库用于为 Agent 提供组织知识依据。
用户可以在前端选择知识库范围,也可以由系统根据当前业务场景和 Skill 绑定关系自动确定默认范围。
知识库增强的一般流程是:
flowchart LR
    A["用户问题"] --> B["计算用户授权知识范围"]
    B --> C["结合用户手选范围"]
    C --> D["结合 Skill 绑定范围"]
    D --> E["生成 knowledgeAccess"]
    E --> F["share-harness 调用 knowledge_search / knowledge_qa"]
    F --> G["装配引用证据"]
    G --> H["生成回答"]
知识库检索必须遵守权限边界。
OpenViking 负责“哪些内容能被检索到”,FlowNex 负责“当前用户是否有资格检索这些内容”。因此,每次运行时检索前,都需要由本地系统计算可信的授权范围。
知识库增强回答应尽量返回引用来源,帮助用户判断回答依据。例如:
根据《项目交付 SOP》第 3.2 节,交付验收前需要完成需求确认、测试报告、上线清单和风险备案。
如果知识库不可用,系统应允许主对话链路降级运行,并在需要时提示用户当前回答未使用组织知识依据。
2.5 查看任务过程、文件产物和执行结果
企业级 Agent 不能只展示最终回答,还需要展示执行过程。
FlowNex 应支持用户和管理员查看:
- 本轮任务状态。
- 执行步骤。
- 工具调用摘要。
- Skill 命中情况。
- 知识库命中情况。
- 引用证据。
- 输入附件。
- 输出文件。
- 错误原因。
- 用户反馈。
在 AGFS 接入后,文件产物会进一步具备:
- 文件版本。
- 文件血缘。
- 文件所属任务。
- 文件所属 Agent。
- 文件 checkpoint。
- 文件回滚能力。
- 知识候选状态。
这使得 FlowNex 可以从普通的“聊天记录系统”升级为“任务执行和知识资产沉淀系统”。
3. 核心概念
3.1 Agent
Agent 是 FlowNex 中面向用户提供智能能力的执行主体。
一个 Agent 并不等同于一个大模型。Agent 是由模型、提示词、Skill、Tool、知识库、运行时策略、权限范围和上下文状态共同组成的业务能力单元。
Agent 可以具备:
- 默认模型配置。
- 默认风格。
- 默认 Tool 集合。
- 默认 Skill 集合。
- 默认知识库范围。
- 渠道接入配置。
- 运行时上下文策略。
在多 Agent 框架中,Agent 还可以承担不同角色,例如 Planner、Researcher、Executor、Reviewer 和 Synthesizer。
FlowNex 的目标不是只运行一个万能 Agent,而是让企业可以按业务场景配置不同 Agent,并在需要时让多个 Agent 协作完成复杂任务。
3.2 Conversation
Conversation 表示一次连续对话上下文。
它用于组织同一用户和 Agent 之间的多轮消息、任务、文件和状态。一个 Conversation 下可以包含多条 Message,也可以包含多个 Task。
Conversation 的主要作用:
- 保存多轮对话历史。
- 关联用户和 Agent。
- 支撑上下文恢复。
- 关联运行时实例。
- 关联任务和文件。
- 支撑跨轮追问。
需要注意的是,Conversation 不应被视为长期知识库。
长期、稳定、可复用的组织知识应进入知识库;运行时文件应进入 AGFS;可复用经验应进入 Memory、Skill 附录、知识草稿或评测集。Conversation 更适合保存当前对话过程和短期上下文。
3.3 Task 与 Task Step
Task 表示一次可执行、可追踪的 Agent 工作单元。
Task 可以由用户消息触发,也可以由定时任务、飞书入站消息、系统自动化或多 Agent Planner 触发。
Task 记录:
- 任务 ID。
- 会话 ID。
- 来源消息 ID。
- 用户 ID。
- 业务类型。
- 任务状态。
- 运行时配置。
- Skill 和 Tool 授权。
- 开始时间和结束时间。
- 最终结果。
Task Step 表示任务中的阶段性执行记录。
Task Step 可以记录:
- 当前步骤编号。
- 步骤类型。
- 步骤状态。
- 步骤内容。
- 关联文件。
- 开始和完成时间。
Task 与 Task Step 的设计让 Agent 执行过程具备结构化可观测能力。后续多 Agent 协作中,Task 还会进一步扩展为任务图节点。
3.4 Skill
Skill 是可复用的 Agent 专业能力单元。
它负责把一类任务的执行经验、约束和最佳实践固化下来,让 Agent 在面对专业任务时不只依赖通用模型能力。
Skill 通常包含:
- Skill 编码。
- 名称和描述。
- 适用场景。
- 执行策略。
- 输入输出约束。
- 可使用脚本或工作流。
- 依赖工具。
- 绑定知识范围。
- 审核、发布和安装状态。
Skill 与 Tool 的区别是:
- Tool 是可调用动作。
- Skill 是完成一类任务的方法。
例如,web_search 是 Tool,而“行业研究报告生成”是 Skill。该 Skill 可能会指导 Agent 调用 web_search、读取知识库、生成大纲、分析资料并输出报告。
Skill 与知识库的区别是:
- Skill 负责怎么做。
- 知识库负责依据什么做。
业务型 Skill 绑定知识库后,可以显著提升执行稳定性和可解释性。
3.5 Tool
Tool 是 Agent 可以调用的外部能力。
Tool 可以由 share-harness 内置,也可以由业务系统通过能力注册方式提供。
常见 Tool 包括:
- 文件读取。
- 文件写入。
- Shell 执行。
- Web 搜索。
- 远程文件搜索和恢复。
- 飞书文档、日历、审批、消息接口。
- 知识库检索。
- AGFS 文件操作。
- 企业内部业务 API。
在 FlowNex 中,Tool 需要被权限和运行策略约束。
toolCodes 表示本轮外部工具授权列表。基础文件工具和 runtime 内置能力不应简单混入外部授权列表,而应由 share-harness 运行时策略统一控制。
Tool 调用的结果应进入任务轨迹,并在必要时做输出裁剪、摘要化和错误映射,避免大体量工具输出污染模型上下文。
3.5.1 AI 应用、原子能力与 Skill 的关系
接入方案上线后,FlowNex 需要同时管理三类能力对象:
| 概念 | 定位 | 示例 | 与 FlowNex 的关系 |
|---|---|---|---|
| AI 应用 | 面向业务场景的完整应用 | 请假助手、报销助手、瑞幸下单助手、数据分析助手 | 可以接入 FlowNex 作为一个业务入口、Agent 能力包或外部应用 |
| 原子化 AI 能力 | 可被复用的最小能力单元 | OCR、合同条款识别、审批查询、订单创建、报表生成 | 注册到能力目录后由 FlowNex 统一授权、路由、观测 |
| Skill | Agent 面向任务的方法封装 | 合同评审 Skill、项目周报 Skill | 可以调用一个或多个原子能力,也可以把原子能力包装成用户可理解的专业任务能力 |
| Tool | Agent 可执行的动作接口 | approval_query、create_order、ocr_extract |
可以来自 FlowNex 内置,也可以来自业务线 Capability Adapter |
推荐边界如下:
- AI 应用回答“业务用户从哪里进入、完成什么场景”。
- Skill 回答“Agent 如何完成这类任务”。
- Tool 回答“Agent 可以执行哪些动作”。
- 原子能力回答“底层由哪个业务线或 Provider 提供稳定能力”。
为了避免能力接入后形成新的烟囱,FlowNex 需要引入以下核心对象:
| 对象 | 说明 |
|---|---|
| Capability | 平台统一管理的能力定义,包含编码、名称、版本、输入输出 Schema、能力类型、负责人和状态 |
| Capability Provider | 能力真实提供方,可以是业务线系统、算法服务、第三方平台或 FlowNex 自研服务 |
| Provider Adapter | control-center 内部的 Provider 适配实现,屏蔽不同 Provider 协议、鉴权、错误码和数据结构差异 |
| Capability Gateway | control-center 内部的能力调用治理入口,负责路由、鉴权、限流、审计、Trace 和降级 |
| Tenant Capability Config | 租户、部门、角色维度的能力开通、启停和配额配置 |
一个典型调用关系是:
前端 AI 应用
  -> ai-app-runtime-gateway /application/**
  -> ai-app-service
  -> control-center 能力中心
  -> Capability Gateway(control-center 内部)
  -> Provider Adapter(control-center 内部)
  -> 业务线 AI 能力 / 业务系统 API
对于 Agent / Skill / Tool 触发的原子能力调用,也同样进入 control-center 能力中心,再由内部的 Capability Gateway 和 Provider Adapter 完成治理与适配。这样设计后,用户侧不需要关心能力来自 FlowNex 自研还是业务线接入;管理员侧可以统一开通、授权、审计和运营;开发侧可以通过统一 Adapter 规范接入不同业务线能力。
3.6 Knowledge Base
Knowledge Base 表示可供 Agent 检索的组织知识库。
FlowNex 当前接入 OpenViking 知识库作为组织知识检索底座。本地系统只保存知识资产元数据、远端资源标识、可见范围和映射状态,不长期保存知识正文。
知识库可以包含:
- 制度。
- SOP。
- FAQ。
- 项目资料。
- 会议纪要。
- 交付模板。
- 历史案例。
- 产品说明。
Knowledge Base 的关键不是“把文档塞进去”,而是建立可治理的组织知识上下文:
- 哪些知识可被哪些租户使用。
- 哪些知识可被哪些角色访问。
- 哪些知识适合绑定到哪些 Skill。
- 哪些知识在运行时被命中。
- 哪些知识过期、低命中或召回质量差。
知识库的运行时访问通过 knowledgeAccess 控制。该对象由 control-center 根据用户授权、用户手选范围和 Skill 绑定范围计算后下发给 runtime。
3.7 AGFS Workspace
AGFS Workspace 是 Agent 执行任务时看到的文件工作区。
与普通本地临时目录不同,AGFS Workspace 具备以下能力:
- 跨实例访问。
- 多 Agent 共享。
- 文件版本历史。
- 文件级权限。
- 任务 checkpoint。
- 快照回滚。
- 文件血缘。
- 知识候选沉淀。
AGFS Workspace 的核心目标是让 Agent 像使用本地文件系统一样使用企业级共享文件系统。
从 Agent 或工具视角看,文件就是普通路径:
/workspace/project-a/requirements.md
/workspace/project-a/data/source.xlsx
/workspace/project-a/output/report.md
但在底层,这些路径会映射到 AGFS 的 space、mount、file node、object storage 和 version tree。
AGFS Workspace 是多 Agent 协作的关键基础设施。没有共享工作区,多 Agent 很容易退化成多个孤立对话;有了 AGFS,多 Agent 才能围绕同一批文件和任务产物真正协作。
3.8 Memory 与经验沉淀
Memory 表示从用户偏好、任务轨迹、长期交互和运行结果中沉淀出的稳定经验。
Memory 不等于聊天记录,也不等于文件全文。
合理的边界是:
- Conversation 保存对话过程。
- Knowledge Base 保存组织知识。
- AGFS 保存文件和产物。
- Memory 保存稳定偏好、经验、决策和长期上下文。
例如:
- 用户偏好“报告先给结论,再给数据依据”可以进入用户 Memory。
- 项目长期决策“该项目采用 Redis 绑定 runtime 实例”可以进入项目 Memory。
- 某个 Skill 高频失败原因可以进入 Agent 全局 Memory 或 runtime reminder。
经验沉淀不应无审计地直接改公共 Skill。推荐流程是:
任务轨迹 / badcase / 用户反馈
  -> 反思抽取
  -> 经验候选
  -> 审核或评测
  -> Skill 附录 / Runtime Reminder / 知识草稿 / Eval Case
3.9 Multi-Agent Task Graph
Multi-Agent Task Graph 表示多 Agent 协作时的任务图。
复杂任务通常不能由一个 Agent 单步完成。例如:
帮我基于项目资料、最近会议纪要和销售数据,生成一份客户经营分析报告,并检查是否符合公司模板。
这个任务可以拆成:
- Researcher 检索项目资料和会议纪要。
- Data Analyst 清洗和分析销售数据。
- Writer 生成报告。
- Reviewer 检查模板和风险。
- Synthesizer 输出最终版本。
Multi-Agent Task Graph 用于描述:
- 子任务之间的依赖关系。
- 每个子任务由哪个 Agent 角色负责。
- 子任务输入和输出。
- 子任务状态。
- 子任务使用的知识和文件。
- 失败后的重试、回滚或人工介入。
AGFS 是 Task Graph 的共享文件底座,Knowledge Base 是 Task Graph 的共享知识底座。
3.10 Capability Snapshot
Capability Snapshot 表示某一轮任务实际可用能力的快照。
它解决的问题是:
同一个用户、同一个 Agent,在不同时间、不同渠道、不同权限条件下,可用能力可能不同。
一次任务开始时,系统需要冻结本轮可用能力,避免执行过程中配置变化导致不可复现。
Capability Snapshot 通常包含:
- 当前可用 Tool。
- 当前可用 Skill。
- 当前知识库授权范围。
- 当前模型配置。
- 当前渠道能力。
- 当前运行时策略。
- 当前 AGFS workspace 或 mount 信息。
Capability Snapshot 对排障和审计非常重要。
当用户问“为什么这次没有使用某个 Skill”或“为什么没有查到某个知识库”时,平台可以基于快照回答:
- 该 Skill 当时未授权。
- 该知识库当时不可见。
- 该 Tool 当时未在本轮授权列表中。
- 该模型配置当时不支持某类能力。
- 该文件当时不在当前 AGFS workspace 中。
4. 用户指南
User Guide 面向 FlowNex 的普通使用者,说明如何通过对话、任务、Skill、知识库和文件能力完成日常工作。
普通用户通常不需要理解底层服务模块,但需要知道:
- 如何发起任务。
- 如何选择或使用 Skill。
- 如何让 Agent 使用知识库。
- 如何上传和获取文件。
- 如何查看执行过程。
- 如何反馈结果质量。
4.1 对话与任务
用户可以通过 Web 客户端、飞书 / Lark 或其他接入渠道向 Agent 发起对话。
一次对话输入会被系统建模为一条消息和一个任务。用户看到的是自然语言交互,系统内部会记录完整任务过程。
常见输入包括:
帮我总结这份文档。
帮我基于附件生成一份会议纪要。
帮我查询公司报销制度。
帮我根据这个项目资料写一份交付方案。
帮我分析这张销售数据表,并输出图表和结论。
任务运行过程中,用户可以看到:
- Agent 是否开始执行。
- 当前是否正在读取文件。
- 当前是否正在检索知识库。
- 当前是否调用工具。
- 当前是否生成文件。
- 最终回答和交付文件。
如果任务失败,系统应返回尽可能明确的失败原因,例如知识库不可用、文件格式不支持、工具调用失败、权限不足或模型输出异常。
4.2 技能市场与我的技能
技能市场用于展示当前用户可安装或可使用的 Skill。
用户可以在技能市场中查看:
- Skill 名称。
- Skill 描述。
- 适用场景。
- 所属分类。
- 作者或维护团队。
- 是否已安装。
- 是否需要额外知识库或工具权限。
用户安装 Skill 后,该 Skill 会进入“我的技能”。后续用户在对话中可以显式选择该 Skill,或让系统根据任务意图自动推荐。
例如:
使用「项目周报生成」技能,帮我根据这些会议纪要生成本周项目周报。
用户需要理解的是:
- Skill 不是固定按钮,而是一组可复用任务方法。
- 安装 Skill 表示用户获得了该能力的使用入口。
- 真正运行时是否能成功,还取决于本轮 Tool、知识库和文件权限。
4.3 知识库选择与引用
知识库用于提供企业内部资料依据。
用户可以在发起任务时选择知识库范围,也可以使用系统默认知识范围。
适合使用知识库的任务包括:
- 制度问答。
- SOP 查询。
- 项目资料总结。
- 基于模板生成文档。
- 基于历史案例输出建议。
- 产品能力和报价规则查询。
用户选择知识库后,系统仍会进行权限校验。用户无权限的知识库不会进入本轮检索范围。
如果本轮回答使用了知识库,结果中应尽量展示引用来源,例如:
依据《差旅报销制度》第 2.1 节,员工出差前需要完成审批流程。
如果知识库没有召回结果,Agent 应说明当前没有找到足够依据,并避免把不确定内容伪装成制度或事实。
4.4 文件上传、生成与恢复
用户可以在对话中上传文件,例如:
- Word 文档。
- PDF。
- Excel 表格。
- 图片。
- Markdown。
- 文本文件。
- 数据文件。
Agent 可以读取这些文件,并基于文件内容完成总结、分析、转换、生成报告等任务。
当前文件通常经过 OSS 或运行时文件恢复机制进入任务上下文。后续 AGFS 接入后,文件会进入标准 workspace,并具备更强能力:
- 文件可跨轮继续使用。
- 文件可被多个 Agent 共享。
- 文件有版本历史。
- 文件可通过 checkpoint 回滚。
- 文件产物可沉淀为知识候选。
用户在任务结束后可以查看 Agent 生成的文件,例如报告、表格、图片、PPT 或结构化数据。
4.5 定时任务与自动化
FlowNex 支持定时任务和自动化任务。
典型场景包括:
- 每天生成日报。
- 每周生成项目周报。
- 定时汇总飞书群消息。
- 定时检查业务指标。
- 定时生成运营报告。
定时任务通常需要配置:
- 任务名称。
- 触发周期。
- 默认 Skill。
- 默认 Tool。
- 默认知识库范围。
- 输出渠道。
- 失败通知策略。
定时任务执行后,也会形成普通任务记录,因此可以查看执行过程、结果文件、错误信息和历史记录。
4.6 飞书 / Lark 渠道接入
FlowNex 可以通过飞书 / Lark 渠道触发 Agent。
用户可以在飞书中:
- 私聊 Agent。
- 在群聊中提及 Agent。
- 上传附件让 Agent 处理。
- 触发审批、日历、任务、文档相关操作。
- 接收 Agent 生成的结果。
渠道接入时需要注意:
- 飞书用户身份需要映射到 FlowNex 用户身份。
- 飞书附件需要进入运行时可读文件范围。
- 飞书 API 调用需要用户或应用授权。
- 群聊场景要避免越权读取其他人的上下文。
- 输出结果需要符合渠道消息格式限制。
4.7 用户反馈与任务评价
用户可以对 Agent 回复进行点赞、点踩或补充反馈。
用户反馈的价值不只是评价体验,也会成为后续能力演进输入。
反馈可以用于:
- 识别 badcase。
- 判断知识召回是否准确。
- 判断 Skill 是否适用。
- 判断输出格式是否符合预期。
- 生成评测样本。
- 沉淀 runtime reminder 或 Skill 改进建议。
为了避免错误经验污染系统,用户反馈不会直接修改公共 Skill 或知识库,而是进入可审计的经验候选流程。
5. 管理员指南
Admin Guide 面向租户管理员、平台管理员和运营人员,说明如何管理 FlowNex 中的用户、权限、Skill、知识库、模型、运行时和审计能力。
管理员的目标不是直接参与每一次 Agent 对话,而是保证企业内部 Agent 能力可控、可复用、可观测。
5.1 租户、用户与角色管理
FlowNex 按租户隔离业务数据和能力范围。
租户下可以管理:
- 用户。
- 角色。
- 部门。
- Agent 配置。
- Skill 可见范围。
- Tool 可用范围。
- 知识库可见范围。
- AGFS 空间权限。
用户身份通常来自企业账号体系或外部渠道映射,例如飞书用户身份。
角色用于聚合权限,例如:
- 普通员工。
- 部门管理员。
- 项目负责人。
- Skill 审核员。
- 知识库管理员。
- 平台管理员。
- 能力接入管理员。
- 业务线能力负责人。
5.2 RBAC 权限模型
FlowNex 的 RBAC 权限模型需要覆盖多类资源:
- 页面和菜单权限。
- API 操作权限。
- Skill 使用权限。
- Tool 使用权限。
- 知识库访问权限。
- 文件访问权限。
- 管理操作权限。
权限判断需要发生在多个阶段:
- 前端展示时裁剪用户可见功能。
control-center接口层校验操作权限。- 运行时任务下发前计算能力快照。
- 知识检索前计算授权范围。
- AGFS 文件读取前校验文件权限。
特别需要注意:
用户拥有某个 Skill,不代表自动拥有该 Skill 绑定知识库的访问权限。
运行时必须取 Skill 权限和知识权限的交集。
5.3 Skill 审核、发布、安装与预装
Skill 是企业 Agent 能力的重要资产,需要经过治理流程。
推荐生命周期:
DRAFT -> PENDING_REVIEW -> PUBLISHED -> INSTALLED -> ENABLED
                          -> REJECTED
                          -> OFFLINE
管理员可以:
- 审核用户提交的 Skill。
- 发布企业级 Skill。
- 将 Skill 预装给部门或角色。
- 下线存在风险的 Skill。
- 查看 Skill 使用情况。
- 管理 Skill 与知识库绑定。
Skill 审核时建议检查:
- Skill 描述是否清晰。
- 是否存在越权工具调用风险。
- 输出格式是否稳定。
- 是否依赖未授权知识。
- 是否需要绑定默认知识库。
- 是否具备示例和边界说明。
5.4 知识库映射与可见范围
FlowNex 当前接入 OpenViking 知识库作为组织知识检索底座。
管理员在 OpenViking 后台完成知识库创建、飞书文档接入、解析和索引构建后,需要在 FlowNex 管理侧维护本地映射。
本地映射记录应包含:
- 知识资产名称。
- 业务编码。
- OpenViking
providerResourceId。 - 所属租户。
- 可见角色。
- 可见部门。
- 可见项目。
- 启停状态。
- 描述和标签。
FlowNex 本地不长期保存知识正文,避免形成双真相。
知识库可见范围的计算应以本地权限为准。OpenViking 负责检索,FlowNex 负责决定当前用户能检索哪些知识。
5.5 Skill 与知识库绑定
管理员可以为业务型 Skill 配置知识库绑定。
绑定关系用于告诉运行时:
- 这个 Skill 优先使用哪些知识。
- 这个 Skill 必须依赖哪些知识。
- 这个 Skill 禁止使用哪些知识。
推荐绑定类型:
| 类型 | 管理含义 |
|---|---|
REQUIRED |
缺少该知识范围时,Skill 应降级或提示无法完整执行 |
PREFERRED |
优先使用该知识范围,召回不足时可扩展 |
OPTIONAL |
作为补充知识范围 |
FORBIDDEN |
禁止该 Skill 使用该知识范围 |
管理员不应给所有 Skill 强制绑定知识。
建议优先绑定:
- 合同、财务、制度、审批等高风险 Skill。
- 项目交付、售前方案等强业务上下文 Skill。
- 需要固定模板、案例和规则的 Skill。
绑定配置完成后,运行时会在用户授权范围、Skill 绑定范围和用户本轮手选范围之间取交集。
5.6 Agent 能力包管理
Agent 能力包是面向业务场景的一组能力组合。
一个能力包可以包含:
- 默认 Agent 配置。
- 默认模型配置。
- 默认 Skill 集合。
- 默认 Tool 集合。
- 默认知识库范围。
- 默认 AGFS 项目空间。
- 输出格式和风格。
- 安全边界。
例如:
项目交付助手能力包 =
  项目周报 Skill
  会议纪要 Skill
  技术方案 Skill
  项目 SOP 知识库
  项目资料知识库
  AGFS 项目空间
能力包的价值是降低业务团队使用门槛,让管理员可以把复杂能力配置沉淀成可复用模板。
5.6.1 能力目录与业务线接入管理
接入方案上线后,管理台需要新增“能力管理”入口,用于承接业务线 AI 应用和原子化 AI 能力的接入、授权、运营和治理。
能力管理至少包含以下对象:
| 管理对象 | 说明 |
|---|---|
| Capability Registry | 统一能力目录,维护能力编码、名称、描述、类型、版本、输入输出 Schema、负责人、状态 |
| Capability Provider | 能力提供方,维护业务线、服务地址、鉴权方式、SLA、联系人和降级策略 |
| Provider Adapter | 能力适配配置,维护协议转换、字段映射、错误码映射、超时、重试和限流策略 |
| Tenant Capability Config | 租户级开通配置,控制哪些租户、部门、角色可以使用哪些能力 |
| Capability Operation Report | 能力运营报表,按业务线、租户、能力、Agent、Skill 统计调用量、成功率、耗时和成本 |
管理员在接入一个业务线能力时,需要完成:
- 登记能力元数据。
- 定义输入输出 Schema。
- 绑定 Provider 和 Adapter。
- 配置租户、部门、角色可见范围。
- 配置是否可作为 Tool 暴露给 Agent。
- 配置是否允许封装为 Skill。
- 配置调用限流、超时、重试和降级。
- 配置 Trace、审计和指标采集。
- 完成联调、灰度和验收。
业务线 AI 应用接入 FlowNex 时,也应进入能力目录。完整 AI 应用可以被表达为:
- 一个外部应用入口。
- 一个 FlowNex Agent 能力包。
- 一组可复用原子能力。
- 一个或多个面向用户的 Skill。
平台管理员关注统一治理,业务线能力负责人关注能力可用性和业务效果。两者需要共享同一套能力目录、调用 Trace 和运营指标,避免接入后只“能调用”,但不可管、不可查、不可运营。
5.7 运行时配置与模型配置
管理员需要配置不同场景使用的模型和运行时参数。
常见配置包括:
- 默认模型。
- 备用模型。
- 最大上下文窗口。
- 推理温度。
- 工具调用策略。
- Skill 选择策略。
- 知识检索 topK。
- 上下文预算比例。
- 超预算裁剪策略。
- Runtime 并发和超时。
不同任务类型可以使用不同模型配置。例如:
- 普通问答使用低成本模型。
- 合同评审使用高可靠模型。
- 复杂多 Agent 任务使用更长上下文模型。
- 数据分析任务允许 Shell 或 Python 工具。
运行时配置应支持灰度,避免配置变更影响所有用户。
5.8 审计、回放与运营报表
管理员需要能够回答:
- 某次任务用了哪些 Skill。
- 某次任务调用了哪些 Tool。
- 某次任务检索了哪些知识。
- 某次任务生成了哪些文件。
- 某个文件由哪个任务或 Agent 生成。
- 某个 Skill 最近失败率为什么升高。
- 哪些知识库命中率低。
- 哪些用户反馈集中在某类问题。
因此,FlowNex 需要提供审计和运营报表:
- 任务执行轨迹。
- Runtime 事件流。
- 知识命中统计。
- Skill 使用统计。
- Tool 调用统计。
- AGFS 文件变更统计。
- 多 Agent 子任务状态。
- 用户反馈分析。
这些数据既用于运维排障,也用于能力演进。
6. 系统架构
本章描述 FlowNex 的系统架构、服务职责、主调用链路和关键运行时流程。
FlowNex 不是单体应用,而是由多个 Java 服务、一个 Python Agent Runtime、公共能力库和外部基础设施共同组成的联合作业系统。
6.1 总体架构
FlowNex 的总体架构可以分为六层:
- 接入层。
- 编排层。
- 能力接入与治理层。
- 领域层。
- 运行时层。
- 基础设施层。
flowchart TB
    subgraph Client["客户端 / 外部渠道"]
        Web["FlowNex Web 前端"]
        Lark["飞书 / Lark"]
        Ding["钉钉 / DingTalk"]
        APIClient["业务系统 API Client"]
        AIApp["AI 应用中心前端应用"]
    end

    subgraph Ingress["双网关接入层"]
        CLAWGW["ai-claw-gateway<br/>FlowNex 主站 / 非 AI 应用入口交互"]
        AIGW["ai-app-runtime-gateway<br/>/application/**"]
    end

    subgraph AppService["AI 应用聚合层"]
        APP["ai-app-service<br/>应用交互 API / 业务语义接口 / 业务数据落库"]
    end

    subgraph Control["能力中心与编排层"]
        CS["control-center"]
        CGW["Capability Gateway<br/>control-center 内部实现"]
        REG["Capability Registry"]
        ADP["Provider Adapter<br/>control-center 内部实现"]
    end

    subgraph Domain["领域层"]
        UDS["user-domain-service"]
        ADS["agent-domain-service"]
    end

    subgraph Runtime["运行时层"]
        RTG["agent-runtime-gateway"]
        SH["share-harness"]
    end

    subgraph Infra["基础设施"]
        DB["MySQL"]
        Redis["Redis"]
        MQ["RocketMQ"]
        OSS["OSS"]
        OV["OpenViking Knowledge Base"]
        AGFS["AGFS"]
        BIZAI["业务线 AI 能力 / 原子能力"]
    end

    Web --> CLAWGW
    Lark --> CLAWGW
    Ding --> CLAWGW
    APIClient --> CLAWGW
    AIApp --> AIGW
    AIGW --> APP
    CLAWGW --> CS
    APP --> CS
    CS --> CGW
    CGW --> REG
    CGW --> ADP
    ADP --> BIZAI
    CS --> UDS
    CS --> ADS
    CS --> RTG
    RTG --> SH
    SH --> RTG
    RTG --> APP
    APP --> AIGW

    UDS --> DB
    ADS --> DB
    APP --> DB
    CS --> MQ
    RTG --> Redis
    RTG --> MQ
    SH --> OSS
    SH --> OV
    SH --> AGFS
主链路可以概括为:
FlowNex 主站 / 非 AI 应用入口
  -> ai-claw-gateway
  -> control-center
  -> agent-runtime-gateway
  -> share-harness
  -> agent-runtime-gateway
  -> control-center
  -> ai-claw-gateway
  -> FlowNex 主站 / 外部渠道
AI 应用中心链路可以概括为:
AI 应用中心应用
  -> ai-app-runtime-gateway /application/**
  -> ai-app-service
  -> control-center
  -> agent-runtime-gateway
  -> share-harness
  -> agent-runtime-gateway
  -> ai-app-service
  -> ai-app-runtime-gateway
  -> AI 应用中心应用
业务线 AI 能力接入后的扩展链路是:
AI 应用中心前端应用
  -> ai-app-runtime-gateway /application/**
  -> ai-app-service
  -> control-center 能力中心
  -> Capability Gateway(control-center 内部)
  -> Provider Adapter(control-center 内部)
  -> 业务线 AI 应用或原子化 AI 能力
  -> Provider Adapter(control-center 内部)
  -> Capability Gateway(control-center 内部)
  -> Runtime 事件和任务轨迹
现有入口触发原子能力时,不经过 ai-app-service:
Web 前端 / 飞书 / 钉钉 / Agent / Skill / Tool
  -> ai-claw-gateway 或 Runtime 内部链路
  -> control-center 能力中心
  -> Capability Gateway(control-center 内部)
  -> Provider Adapter(control-center 内部)
  -> 业务线 AI 应用或原子化 AI 能力
6.1.1 业务线 AI 能力接入架构
业务线 AI 应用和原子化 AI 能力不应直接暴露给 Agent Runtime 或前端业务层。真实链路需要区分两类入口:
- FlowNex 主站交互链路:Web 前端、对话入口、任务中心、Skill 市场、知识库管理、管理台、飞书、钉钉等非 AI 应用入口交互,仍统一经过
ai-claw-gateway -> control-center。 - AI 应用中心接入链路:前端 AI 应用通过
ai-app-runtime-gateway的application前缀路由进入ai-app-service,由ai-app-service提供应用层交互接口、业务语义接口和业务数据落库。典型应用包括行云 AI 算力专项学习服务、会议智能总结、智能项目管理、智能标书。 - 原子 AI 能力调用链路:只有 AI 应用中心前端应用发起的应用侧请求才会经过
ai-app-runtime-gateway -> ai-app-service -> control-center;现有 Web 前端、飞书、钉钉、Agent、Skill 或 Tool 仍经过ai-claw-gateway -> control-center或运行时内部链路进入能力中心。
Capability Gateway 和 Provider Adapter 均属于 control-center 内部实现,不作为独立应用部署,也不单独暴露给前端或业务线。
flowchart TB
    Main["Web 前端 / 飞书 / 钉钉 / 管理台"] --> CLW["ai-claw-gateway"]
    FE["AI 应用中心应用<br/>算力学习 / 会议总结 / 项目管理 / 智能标书"] --> GW["ai-app-runtime-gateway<br/>application 前缀路由"]
    CLW --> CS["control-center<br/>能力中心"]
    GW --> APP["ai-app-service<br/>应用交互接口 / 业务语义接口 / 业务数据落库"]
    APP --> CS["control-center<br/>能力中心"]

    subgraph Internal["control-center 内部实现"]
        CGW["Capability Gateway"]
        REG["Capability Registry"]
        ADP["Provider Adapter"]
        AUTH["租户授权 / 角色权限 / 配额"]
        OBS["Trace / Audit / Metrics / Evaluation"]
    end

    CS --> CGW
    CGW --> REG
    CGW --> AUTH
    CGW --> ADP
    CGW --> OBS
    ADP --> BIZ["业务线 AI 能力 / 原子能力 / 业务系统 API"]

    APP --> RTG["agent-runtime-gateway"]
    RTG --> SH["share-harness<br/>Agent / Skill / Tool 执行"]
    SH --> CS
这层设计承担以下职责:
| 模块 | 职责 |
|---|---|
| ai-claw-gateway | FlowNex 现有主链路网关,承接 AI 应用入口之外的所有交互,包括 Web 前端、对话、任务中心、Skill、知识库、管理台、飞书、钉钉等 |
| ai-app-runtime-gateway | AI 应用中心专用接入网关层,通过 application 前缀路径承接 AI 应用中心所有 AI 应用请求调用 |
| ai-app-service | 后端 AI 应用聚合代码仓库,只服务从 AI 应用中心前端应用侧进入的请求,提供应用层交互业务接口、业务语义接口和业务数据落库能力 |
| control-center | 能力中心所在服务,承接原子 AI 能力调用、能力管理、能力授权、路由治理和 Provider 适配 |
| Capability Gateway | control-center 内部能力调用治理模块,负责路由、鉴权、限流、审计、Trace、降级和错误映射 |
| Capability Registry | control-center 内部能力目录模块,保存能力元数据、输入输出 Schema、版本、负责人、适用租户和状态 |
| Provider Adapter | control-center 内部 Provider 适配实现,适配不同业务线协议、鉴权方式、字段结构、错误码、超时和重试策略 |
| Tenant Capability Config | 控制租户、部门、角色、Agent、Skill 对能力的可见和可用范围 |
| Observability Binding | 将能力调用纳入任务 Trace、运行指标、调用成本、自动回归和质量评估 |
新增这层后,FlowNex 的架构边界更清晰:
ai-app-runtime-gateway只负责 AI 应用入口路由,不承载业务语义。ai-claw-gateway负责 FlowNex Web 前端、主站、管理台、飞书、钉钉和非 AI 应用入口的交互接入。ai-app-service负责 AI 应用层交互、业务语义接口和业务数据落库。control-center决定本轮任务或前端请求能用哪些原子能力。Capability Gateway作为control-center内部模块负责统一执行能力调用治理。Provider Adapter作为control-center内部实现负责对接具体业务线能力。share-harness仍然负责 Agent 推理、Skill 装配和 Tool 调用,但不直接耦合业务线协议。- 能力元数据、授权、调用关系和审计所需业务真相由
control-center能力中心统一维护,并按需与领域服务协同。
6.2 服务模块划分
ai-claw-gateway
ai-claw-gateway 是 FlowNex 现有主链路网关,负责 AI 应用入口之外的所有产品交互。
负责:
- 承接 FlowNex Web 前端和主站对话入口。
- 承接任务中心、历史会话、文件管理、Skill 市场、知识库管理和管理台请求。
- 承接飞书 / Lark、钉钉 / DingTalk 等外部渠道进入 FlowNex 主链路的请求。
- 透传用户、租户、角色、trace 等可信上下文。
- 对接
control-center、领域服务或运行时回推链路。
不负责:
- AI 应用中心内具体前端应用的
application路由。 - AI 应用业务数据落库。
- 原子 AI 能力的 Provider 适配。
- 最终模型推理。
ai-app-runtime-gateway
ai-app-runtime-gateway 是 AI 应用中心的专用接入网关层,只承接 AI 应用中心前端应用发起的应用侧请求。
负责:
- 承接 AI 应用中心内所有前端 AI 应用请求调用。
- 通过
application前缀路径进行 AI 应用路由。 - 透传用户、租户、trace、来源应用等网关上下文。
- 对接
ai-app-service。 - 承接需要回推给前端的 SSE 或事件流入口。
典型应用包括:
- 行云 AI 算力专项学习服务。
- 会议智能总结。
- 智能项目管理。
- 智能标书。
不负责:
- Agent 任务编排。
- 领域数据处理。
- 模型推理。
- 知识库检索。
- 原子 AI 能力的 Provider 适配。
ai-app-service
ai-app-service 是后端 AI 应用层的聚合代码仓库,只服务通过 ai-app-runtime-gateway 进入的 AI 应用中心应用侧请求。
负责:
- 提供 AI 应用中心前端应用所需的应用层交互业务接口。
- 提供业务语义接口,例如应用会话、页面状态、表单确认、业务动作触发等。
- 负责 AI 应用相关业务数据落库。
- 对接运行时链路,发起 Agent 任务或接收运行时结果。
- 当 AI 应用中心前端应用需要调用原子 AI 能力时,路由到
control-center能力中心。
不负责:
- 现有 Web 前端、飞书、钉钉、主站管理台等非 AI 应用入口交互。
- 原子能力的统一授权、路由、限流和 Provider 适配。
- 最终模型推理。
- Prompt 最终装箱。
- AGFS 文件底层读写。
control-center
control-center 是能力中心与 Agent 编排协同的核心服务。
负责:
- 承接
ai-claw-gateway、ai-app-service、Agent、Skill、Tool 发起的原子 AI 能力调用。 - 管理 Capability 定义、Provider、版本、Schema、租户配置和开通状态。
- 通过内部
Capability Gateway实现能力路由、鉴权、限流、审计、Trace、降级和错误映射。 - 通过内部
Provider Adapter适配具体业务线 AI 能力、第三方 AI Provider 或业务系统 API。 - 计算当前用户、租户、角色、Agent、Skill 可用的 Capability、Tool、Skill 和知识库范围。
- 与
agent-runtime-gateway协同下发运行时任务和能力快照。 - 接收 runtime 回调和能力调用结果摘要,支撑任务轨迹、指标和审计。
- 提供知识库、Skill、权限、运行时配置和能力管理入口。
不负责:
- 前端 AI 应用的业务数据落库。
- 最终模型推理。
- AGFS 文件底层读写。
user-domain-service
user-domain-service 是用户域服务。
负责:
- 用户信息。
- 用户身份。
- 用户 Agent 风格。
- 用户相关领域规则。
- 用户数据持久化。
agent-domain-service
agent-domain-service 是 Agent 业务领域服务。
负责:
- Agent 配置。
- Conversation。
- Message。
- Task。
- Task Step。
- Skill 元数据。
- Skill 安装和审核。
- 知识库本地映射。
- Skill 与知识库绑定关系。
- AGFS 业务映射。
- Agent 侧引用的 Capability 快照。
- Capability 与 Tool、Skill、Agent 能力包之间的映射关系引用。
它保存 Agent 领域业务真相,但不负责运行时推理,也不作为能力中心主数据的归属服务。
agent-runtime-gateway
agent-runtime-gateway 是运行时网关。
负责:
- 会话到 runtime 实例的绑定。
- 运行时实例路由。
init / infer请求转发。- runtime 事件接收。
- SSE 事件回推聚合。
- Redis 运行时状态管理。
- 运行时不可用时的重建和重试。
它不直接接 MySQL,不负责业务领域持久化。
share-harness
share-harness 是实际 Agent Runtime。
负责:
- ReAct / Plan 执行。
- 模型调用。
- Tool 调用。
- Skill 加载和执行。
- 上下文重建。
- 知识检索工具调用。
- 文件读写。
- AGFS workspace 接入。
- Runtime 事件输出。
- 任务结果生成。
share-harness 是运行时装配真相:最终哪些上下文进入本轮模型请求,由它根据策略决定。
6.3 主链路:客户端到 Runtime
用户发起一轮对话时,系统主链路如下:
sequenceDiagram
    participant U as User
    participant M as ai-claw-gateway
    participant G as ai-app-runtime-gateway
    participant P as ai-app-service
    participant C as control-center
    participant A as agent-domain-service
    participant R as agent-runtime-gateway
    participant H as share-harness

    alt FlowNex 主站 / 飞书 / 管理台
        U->>M: 发送消息 / 建立 SSE
        M->>C: 主站交互请求
    else AI 应用中心
        U->>G: application 请求 / 建立 SSE
        G->>P: application 路由转发
        P->>P: 应用交互处理 / 业务数据落库
        P->>C: 发起 Agent 任务或原子能力调用
    end
    C->>A: 创建 Message / Task
    C->>C: 计算 Tool / Skill / KnowledgeAccess
    C->>R: infer(command)
    R->>H: /tasks 或 /infer
    H->>H: 上下文装配 / 模型与工具执行
    H-->>R: runtime events
    alt FlowNex 主站 / 飞书 / 管理台
        R-->>C: runtime events
        C-->>M: SSE push
        M-->>U: 流式输出
    else AI 应用中心
        R-->>P: runtime events
        P-->>G: SSE push
        G-->>U: 流式输出
    end
    H-->>R: finish
    R-->>C: runtime callback
    C->>A: 更新 Task / Message / Step
这个链路中有两个关键设计:
ai-claw-gateway和ai-app-runtime-gateway是双网关关系,分别承接主站交互和 AI 应用中心请求。ai-app-service承担 AI 应用层交互和业务语义,不把应用业务逻辑下沉到网关。control-center在任务下发前完成能力授权和运行时能力快照计算。share-harness在运行时完成最终上下文装箱和工具执行。
6.4 SSE 流式响应链路
SSE 用于向用户实时展示 Agent 执行过程。
典型事件包括:
- 任务开始。
- Planner 输出计划。
- Agent 思考过程摘要。
- Tool 调用开始。
- Tool 调用结果。
- Skill 命中。
- 知识库检索。
- 文件生成。
- 最终回答。
- 任务完成或失败。
SSE 链路按入口分为两类:FlowNex 主站和飞书等非 AI 应用入口由 ai-claw-gateway 承接连接;AI 应用中心内的应用由 ai-app-runtime-gateway 承接 application 路由连接。agent-runtime-gateway 聚合 runtime 事件后,按来源回传给 control-center 或 ai-app-service,再由对应入口推送到前端连接。
SSE 只负责用户侧展示,不应成为业务持久化唯一来源。任务状态和消息结果仍需要通过 runtime callback 进入 control-center 和 agent-domain-service。
6.5 Runtime 回调与任务持久化
Runtime 执行过程中会持续产生事件。
这些事件分为两类:
- 面向用户展示的流式事件。
- 面向业务持久化和审计的结构化事件。
任务完成后,runtime 需要回调:
- 最终回答。
- 任务状态。
- 错误码和错误信息。
- Task Step。
- 文件产物。
- Tool 调用摘要。
- 知识命中摘要。
- token 和耗时指标。
control-center 接收回调后,更新 agent-domain-service 中的消息、任务和步骤状态。
6.6 上下文装配链路
上下文装配是 Agent 运行质量的核心。
一次任务的上下文来源包括:
- System Prompt。
- Agent 身份和风格。
- 当前用户身份。
- Recent Messages。
- 本轮用户输入。
- 本轮附件。
- 本轮可见 Skill。
- 本轮可用 Tool。
- 知识库检索结果。
- AGFS workspace 文件。
- Memory 和经验提醒。
control-center 负责提供业务侧能力快照,share-harness 负责最终装箱。
推荐装配顺序:
基础系统上下文
  -> 用户和 Agent 身份
  -> 本轮消息和附件
  -> 可用 Tool / Skill 轻量目录
  -> 知识检索结果
  -> AGFS 文件上下文
  -> Memory / Runtime Reminder
  -> PromptBudgetPlanner 裁剪
6.7 工具与 Skill 执行链路
Tool 和 Skill 是 Agent 从“会回答”走向“会做事”的关键。
执行链路如下:
flowchart LR
    A["用户任务"] --> B["解析意图"]
    B --> C["选择候选 Skill"]
    C --> D["加载 Skill 说明"]
    D --> E["判断所需 Tool"]
    E --> F["检查本轮 Tool 授权"]
    F --> G["执行 Tool / Skill Script / Workflow"]
    G --> H["写入 Task Step 和事件"]
    H --> I["生成最终结果"]
注意:
- Skill 提供方法和约束。
- Tool 提供动作能力。
- Tool 是否可用由本轮授权决定。
- Skill 是否可用由用户安装、角色权限和 runtime 可见范围决定。
- Skill 绑定知识后,知识权限仍需单独校验。
- Skill 调用业务线原子能力时,仍需经过 Capability Gateway 完成能力级授权和审计。
6.8 知识检索链路
知识检索链路分为授权计算和运行时检索两段。
授权计算在 control-center:
- 查询用户可访问知识范围。
- 解析用户手选知识库。
- 查询本轮 Skill 绑定知识。
- 计算最终
knowledgeAccess。 - 下发给 runtime。
运行时检索在 share-harness:
- 根据任务意图决定是否检索。
- 调用
knowledge_search或knowledge_qa。 - 对结果去重、排序和裁剪。
- 装配引用证据。
- 回传知识命中轨迹。
6.9 AGFS 文件系统链路
AGFS 接入后,运行时文件链路会从“本地临时目录 + OSS 交付”升级为“标准 workspace + 文件系统级版本和回滚”。
AGFS 链路包括:
control-center创建或选择 AGFS space。agent-runtime-gateway下发 mount 信息。share-harness挂载 AGFS workspace。- Agent 和工具通过普通路径读写文件。
- AGFS 记录文件节点、版本和事件。
- 任务结束后,文件产物与 Task、Message、Skill 建立关系。
- 高价值文件进入知识候选。
6.10 多 Agent 协作链路
多 Agent 协作以任务图为核心。
flowchart TD
    A["用户复杂任务"] --> B["Planner 拆解任务"]
    B --> C["Researcher 检索知识"]
    B --> D["Executor 执行工具和文件操作"]
    C --> E["AGFS 共享资料"]
    D --> E
    E --> F["Reviewer 审查结果"]
    F --> G["Synthesizer 汇总输出"]
    G --> H["最终回复 / 文件产物"]
AGFS 为多 Agent 提供共享文件空间,Knowledge Base 为多 Agent 提供共享组织知识,Task Graph 为多 Agent 提供协作结构。
7. 知识库体系
Knowledge System 描述 FlowNex 如何接入、授权、检索、绑定和观测组织知识。

7.1 知识库接入目标
知识库接入的目标是让 Agent 回答和执行任务时具备组织依据。
第一阶段目标:
- 管理侧可以维护 OpenViking 知识库与本地业务资产的映射。
- 管理侧可以维护知识库可见范围。
- 用户可以选择本轮知识库范围。
- Agent 可以通过
knowledge_search和knowledge_qa检索授权知识。 - 检索结果可以作为引用证据进入回答。
- 知识命中可以被记录和分析。
非目标:
- 不在 FlowNex 内自研组织知识向量检索底座。
- 不在本地长期保存知识正文。
- 不让运行时文件进入 OpenViking 管理。
- 不把用户个人文件无差别入库。
7.2 OpenViking 知识库集成
OpenViking 负责组织知识的检索底座。
在第一阶段,知识库创建、飞书云文档接入、解析、分段、索引构建都在 OpenViking 后台完成。FlowNex 只维护本地映射和权限。
本地系统需要保存:
- 知识资产 ID。
- 知识资产编码。
- 知识资产名称。
- OpenViking
providerResourceId。 - Provider 类型。
- 所属租户。
- 可见范围。
- 本地启停状态。
- 检索配置摘要。
这样可以避免知识正文双真相。
7.3 本地知识资产模型
推荐本地知识资产模型包括:
KnowledgeAsset。KnowledgeMapping。KnowledgeAcl。KnowledgeUsageTrace。
KnowledgeAsset
表示本地业务知识资产。
字段建议:
assetId。tenantCode。assetCode。assetName。description。assetType。status。tags。
KnowledgeMapping
表示本地知识资产与外部知识库资源的映射。
字段建议:
mappingId。assetId。providerCode。providerResourceId。externalObjectId。endpointConfig。retrievalConfig。scopeVersion。
KnowledgeAcl
表示知识可见范围。
字段建议:
assetId。tenantCode。scopeType。scopeRef。enabled。
scopeType 可以包括:
TENANT。DEPARTMENT。ROLE。PROJECT。USER。
7.4 知识授权范围计算
知识授权范围计算必须发生在本地业务系统。
计算输入:
tenantCode。userId。- 用户角色。
- 用户部门。
- 用户项目。
- 知识资产状态。
- 知识映射状态。
- 用户本轮手选范围。
- Skill 绑定范围。
计算输出:
{
  "tenantCode": "xingyun",
  "userId": 10001,
  "scopes": [
    {
      "assetId": 1,
      "assetCode": "project-sop",
      "providerCode": "OPEN_VIKING",
      "providerResourceId": "kb_project_sop",
      "scopeVersion": 3
    }
  ]
}
授权范围必须在检索前完成裁剪,而不是检索后再过滤。这样可以避免越权知识被召回到中间结果。
7.5 Runtime Knowledge Access
RuntimeKnowledgeAccess 是 control-center 下发给 runtime 的本轮知识访问快照。
它用于告诉 share-harness:
- 本轮是否允许知识检索。
- 本轮可检索哪些知识库。
- 本轮知识范围来自用户手选、Skill 绑定还是默认授权。
- 是否存在必需知识缺失。
- 是否存在被禁用或被权限裁剪的知识范围。
示例:
{
  "enabled": true,
  "mode": "SKILL_BOUND",
  "providerResourceIds": ["kb_contract", "kb_policy"],
  "requiredMissing": [],
  "trace": {
    "authorizedCount": 5,
    "selectedCount": 2,
    "skillBoundCount": 2,
    "forbiddenDroppedCount": 0
  }
}
运行时不应接收 Provider 凭证、内部 endpoint 配置和未经裁剪的权限信息。
7.6 knowledge_search 与 knowledge_qa
FlowNex 建议在 runtime 中提供两个知识工具:
knowledge_search
用于复杂任务中的资料检索。
适合场景:
- 研究。
- 分析。
- 写作。
- 方案生成。
- 多段证据引用。
返回内容通常包括:
- 文档标题。
- 片段内容。
- 来源知识库。
- 相似度或排序分。
- 引用标识。
knowledge_qa
用于直接问答。
适合场景:
- FAQ。
- 制度查询。
- 明确问题。
- 简短答案。
如果 knowledge_qa 置信度不足,可以降级调用 knowledge_search 获取更多证据。
7.7 Skill-Knowledge Binding
Skill 与知识库绑定用于把业务能力和业务依据关联起来。
实现分工:
agent-domain-service保存绑定关系。control-center管理绑定并计算本轮最终知识范围。agent-runtime-gateway透传knowledgeAccess。share-harness基于knowledgeAccess调用知识工具。
绑定类型:
| 类型 | 运行时语义 |
|---|---|
REQUIRED |
必需知识范围,无权限或缺失时需要降级或提示 |
PREFERRED |
优先检索范围,召回不足时可以扩展 |
OPTIONAL |
补充检索范围 |
FORBIDDEN |
禁止当前 Skill 使用 |
最终范围计算:
最终知识范围 =
    用户授权范围
  ∩ Skill REQUIRED/PREFERRED 绑定范围
  ∩ 用户本轮手选范围,如果存在
  - Skill FORBIDDEN 范围
如果 Skill 没有绑定知识,应回退到用户手选范围或用户默认授权范围。
7.8 知识命中观测与引用追踪
每次知识检索都应记录命中轨迹。
建议记录:
tenantCode。userId。conversationId。taskId。messageId。skillCodes。- 检索 query。
- 检索知识库范围。
- 命中文档。
- 命中片段。
- 最终使用证据。
- 被裁剪原因。
- token 成本。
- 检索耗时。
这些数据用于:
- 展示引用来源。
- 排查回答依据。
- 分析低命中知识库。
- 分析 Skill 绑定是否合理。
- 识别知识缺口。
7.8.1 业务线能力接入后的知识上下文关系
业务线 AI 能力接入 FlowNex 后,知识库不只服务 Agent 问答,也会成为业务线能力调用时的重要上下文资产。
典型关系包括:
| 关系 | 说明 |
|---|---|
| Skill 绑定知识 | Skill 执行时默认使用某些制度、模板、案例和 SOP |
| Capability 绑定知识 | 原子能力调用前需要特定知识作为参数补充或规则依据 |
| Provider 绑定知识 | 某个业务线 Provider 只允许访问其业务域内知识资产 |
| Agent 能力包绑定知识 | 一个业务场景应用默认携带一组知识范围 |
| 租户能力开通绑定知识 | 租户开通某能力时,同步开通与该能力配套的知识资产 |
例如,差旅报销 AI 应用可能包含:
- 报销单识别原子能力。
- 发票验真原子能力。
- 差旅制度知识库。
- 报销流程 Skill。
- 财务审批查询 Tool。
运行时需要同时计算能力授权和知识授权:
用户权限
  ∩ Agent 能力包授权
  ∩ Skill 绑定知识
  ∩ Capability 绑定知识
  ∩ 租户可见知识范围
  -> Runtime KnowledgeAccess
原则上,Capability 绑定知识不能绕过用户和租户 ACL。即使某个业务线能力声明需要某知识库,如果当前用户无权访问,该知识也不能被注入模型上下文或传给外部 Provider。
7.9 降级策略与安全边界
知识库系统必须有明确降级策略。
典型降级场景:
- OpenViking 不可用。
- 知识库超时。
- 用户无可用知识。
- Skill 必需知识缺失。
- 检索结果置信度不足。
- 返回结果超出上下文预算。
处理策略:
- 普通问答可降级为不使用知识库,但需避免声称有组织依据。
REQUIRED知识缺失时,业务型 Skill 应提示无法完整执行。- 检索超时时,主链路应尽量继续运行。
- 越权知识不得进入 runtime。
- 检索结果进入模型前必须经过 token 预算裁剪。
安全边界:
- Provider 凭证不下发给模型。
- endpoint 配置不暴露给前端。
- 未授权知识不进入检索请求。
- 被
FORBIDDEN绑定排除的知识不进入本轮范围。
8. 技能体系
Skill System 描述 FlowNex 如何管理、发布、授权、运行和演进可复用 Agent 能力。
Skill 是 FlowNex 从“通用对话”走向“企业专业任务执行”的关键抽象。
8.1 Skill 的定位
Skill 是一类任务的专业执行方法。
它不是简单提示词,也不是单个工具,而是把完成某类任务所需的规则、步骤、上下文、工具、输出格式和经验沉淀为一个可复用能力单元。
Skill 的目标是让 Agent 面对专业任务时具备稳定行为。
例如:
- 合同评审 Skill:指导 Agent 识别主体、金额、付款、违约、保密、争议解决等条款风险。
- 项目周报 Skill:指导 Agent 按固定结构提取本周进展、风险、阻塞和下周计划。
- 数据分析报告 Skill:指导 Agent 读取数据、计算指标、生成图表和输出结论。
- 飞书审批 Skill:指导 Agent 调用飞书审批接口并处理审批结果。
Skill 的价值在于:
- 降低重复提示词编写成本。
- 固化业务最佳实践。
- 提升输出格式稳定性。
- 限制高风险任务边界。
- 支撑能力发布、授权和运营。
8.2 Skill 元数据模型
Skill 元数据保存于 agent-domain-service,核心表为 t_skill 及相关安装、审核、预装记录。
一个 Skill 至少需要包含:
skillId:Skill 主键。tenantCode:所属租户。skillCode:稳定业务编码。skillName:展示名称。description:能力描述。categoryId:分类。enabled:是否启用。features:运行相关扩展信息。bizFeatures:业务扩展信息。authorUserId:作者。currentVersionId:当前版本。sourceType:来源类型。
后续建议进一步补齐:
contextMode:SELF_CONTAINED / KNOWLEDGE_BOUND / KNOWLEDGE_REQUIRED。defaultKnowledgeStrategy:默认知识策略。executionGuardrails:执行安全边界。runtimeHintL0:运行时轻量提示。requiredToolCodes:建议或必需工具。evaluationStatus:评测状态。
8.3 Skill 生命周期
Skill 生命周期建议采用以下状态机:
stateDiagram-v2
    [*] --> DRAFT
    DRAFT --> PENDING_REVIEW: 提交审核
    PENDING_REVIEW --> PUBLISHED: 审核通过
    PENDING_REVIEW --> REJECTED: 审核拒绝
    REJECTED --> DRAFT: 修改后重新提交
    PUBLISHED --> OFFLINE: 下线
    OFFLINE --> PUBLISHED: 重新上架
    PUBLISHED --> ARCHIVED: 归档
不同阶段的语义:
DRAFT:作者编辑中,不对普通用户可用。PENDING_REVIEW:等待管理员或审核员确认。PUBLISHED:已发布,可被授权和安装。REJECTED:审核未通过,需要修改。OFFLINE:暂时下线,不允许新任务使用。ARCHIVED:历史归档,不再进入市场。
运行时只能消费已发布、已授权、已启用的 Skill。
8.4 Skill 市场
Skill 市场是用户发现和安装能力的入口。
Skill 市场应展示:
- Skill 名称。
- 描述。
- 分类。
- 作者。
- 适用场景。
- 所需工具。
- 绑定知识。
- 安装状态。
- 最近使用量。
- 成功率或评分。
Skill 市场不只是展示页,也是能力运营入口。
管理员可以通过市场观察:
- 哪些 Skill 高频使用。
- 哪些 Skill 安装率高但成功率低。
- 哪些 Skill 依赖知识过期。
- 哪些 Skill 需要补充示例或限制。
- 哪些用户创建的 Skill 可以升级为团队 Skill。
8.5 Skill 安装与授权
Skill 可见不等于 Skill 可用。
一个用户能否使用某个 Skill,至少需要满足:
- Skill 属于当前租户或平台公共范围。
- Skill 已发布。
- Skill 已启用。
- 用户拥有该 Skill 使用权限。
- 用户已安装,或 Skill 被预装给用户所属部门、角色或租户。
- 本轮任务允许该 Skill 进入
skillCodes。
推荐授权模型:
- 平台 Skill:平台统一维护,可按租户开放。
- 企业 Skill:租户管理员维护,对本租户开放。
- 团队 Skill:部门或项目团队维护,对指定范围开放。
- 个人 Skill:用户个人维护,默认只对自己可用。
8.6 Skill 与 Tool 的关系
Skill 和 Tool 是两种不同抽象。
| 概念 | 作用 | 示例 |
|---|---|---|
| Skill | 描述如何完成一类任务 | 合同评审、项目周报、行业研究 |
| Tool | 执行某个动作 | 读文件、调用飞书 API、Web 搜索、运行脚本 |
一个 Skill 可以声明自己建议或依赖哪些 Tool。
例如:
数据分析报告 Skill
  依赖 read_file
  依赖 shell_run
  可选 web_search
  可选 chart_generation
运行时必须检查本轮 Tool 授权。即使 Skill 描述中建议使用某个 Tool,如果本轮 toolCodes 未授权,该 Tool 也不应被注入。
8.7 Skill 与知识库绑定
业务型 Skill 通常需要绑定知识库。
绑定关系用于约束或引导运行时检索范围。
例如:
合同评审 Skill
  REQUIRED: 合同模板知识库
  REQUIRED: 法务风险条款库
  PREFERRED: 历史合同案例库
  FORBIDDEN: 已归档旧制度知识库
第一期建议使用轻量表 t_skill_knowledge_binding 管理绑定。
运行时不直接读取绑定表,而由 control-center 在下发任务前计算 RuntimeKnowledgeAccess。
这样可以保证:
- 权限裁剪发生在运行时之前。
- runtime 不感知业务权限细节。
- 知识范围可以被审计。
- Skill 绑定策略可以灰度演进。
8.8 Skill 执行与 runtime 注入
share-harness 在每轮任务中会根据 skillCodes 解析当前可见 Skill。
推荐运行时处理流程:
flowchart TD
    A["收到 RunCreateRequest"] --> B["解析 skill_codes"]
    B --> C["加载可见 Skill 轻量目录"]
    C --> D["Planner / ReAct 判断是否需要 Skill"]
    D --> E["按需加载完整 SKILL.md"]
    E --> F["读取 references / scripts / workflows"]
    F --> G["检查 Tool 授权"]
    G --> H["执行 Skill 指导下的任务"]
Skill 注入应遵守上下文预算。
不建议每轮把所有完整 Skill 文本都塞进模型。更合理的方式是:
- 先注入 Skill 轻量摘要。
- 命中后再按需读取完整 Skill。
- references 和 scripts 只在需要时读取。
- 超预算时优先保留当前任务最相关 Skill。
8.8.1 从原子能力到 Skill 的封装模型
业务线接入的原子化 AI 能力通常不应直接暴露给最终用户。更推荐的方式是先注册为 Capability,再按需要包装成 Tool 或 Skill。
封装路径如下:
业务线原子能力
  -> Provider Adapter
  -> Capability Registry
  -> Tool 定义
  -> Skill 方法封装
  -> Agent 能力包
不同封装层的职责不同:
| 层级 | 关注点 | 示例 |
|---|---|---|
| Capability | 能力元数据、Schema、版本、Provider、SLA | invoice_ocr_extract |
| Tool | Agent 可调用动作、参数校验、结果裁剪 | extract_invoice_fields |
| Skill | 面向任务的方法、步骤、知识依赖、输出格式 | 差旅报销材料审核 Skill |
| Agent 能力包 | 面向业务场景的能力组合 | 财务报销助手 |
封装原则:
- 原子能力保持小而稳定,不承担复杂业务编排。
- Tool 负责动作调用,不写复杂业务说明。
- Skill 负责把多个 Tool、知识库和输出要求组织成任务方法。
- Agent 能力包负责把一组 Skill、Tool、知识和 AGFS 空间组合成业务场景。
- 能力调用结果必须进入 Task Step 和 Trace,便于排障、审计和评估。
例如,合同审核场景可以这样拆分:
合同文本解析 Capability
  -> contract_parse Tool
  -> 合同评审 Skill
  -> 法务助手 Agent 能力包
这样既能复用底层能力,也能保持用户侧的任务表达足够清晰。
8.9 Skill 演进、评测与灰度
Skill 是可演进资产,但不能无审计自动改写。
推荐演进闭环:
任务轨迹
  -> 用户反馈
  -> badcase 识别
  -> 反思抽取
  -> Skill 改进候选
  -> 离线评测
  -> 灰度发布
  -> 正式发布
Skill 改进可以落到不同位置:
- 主体规则:长期稳定规则。
- 附录:边界条件、示例、反例。
- Runtime Reminder:执行时容易遗漏的短提醒。
- Eval Case:进入评测集。
发布前必须满足:
- 来源可追踪。
- 修改可审计。
- 评测通过。
- 支持灰度。
- 支持回滚。
9. 运行时文件系统(AGFS)
AGFS 是 FlowNex 自建的 Agent Graph File System,用于承载 Agent 运行时文件、任务产物、多 Agent 协作文件、文件版本、快照回滚和知识候选沉淀。

它是 FlowNex 与普通 2C Agent 产品、普通 OSS 附件系统之间的重要分水岭。
9.1 为什么需要 AGFS
Agent 执行任务时会产生大量文件:
- 用户上传附件。
- 中间数据。
- 清洗结果。
- 脚本输出。
- 日志。
- 图表。
- 报告。
- 最终交付物。
如果这些文件只存在本地临时目录或普通 OSS 中,会出现几个问题:
- 跨轮无法稳定继续使用。
- 跨实例恢复复杂。
- 多 Agent 无法实时共享。
- 文件被脚本误删后难以恢复。
- 文件版本和任务血缘不可追踪。
- 高价值产物难以沉淀为知识资产。
AGFS 的目标是让 Agent 的文件世界具备企业级基础设施能力:
可共享
可追踪
可版本化
可回滚
可审计
可沉淀
9.2 AGFS 与普通 OSS 文件管理的区别
OSS 是对象存储,不是文件系统。
OSS 适合保存文件正文,但不擅长处理:
- 目录。
- 重命名。
- 随机写。
- 文件版本语义。
- 多 Agent 实时协作。
- 文件系统级快照。
- POSIX 风格工具兼容。
AGFS 在 OSS 之上提供文件系统语义。
| 能力 | 普通 OSS | AGFS |
|---|---|---|
| 文件正文存储 | 支持 | 支持,底层可复用 OSS |
| 目录树 | 需要模拟 | 原生元数据建模 |
| 路径读写 | 不友好 | 标准文件路径 |
| 多 Agent 共享 | 弱 | 强 |
| 版本历史 | 需要业务自建 | 文件级版本 |
| 快照回滚 | 不支持 | workspace / task checkpoint |
| 文件血缘 | 不支持 | 关联任务、消息、Skill、Agent |
| 工具透明访问 | 弱 | 可通过 FUSE 支持 |
9.3 AGFS 核心概念
AGFS 的核心概念包括:
Space:文件空间,例如用户空间、项目空间、任务空间。Mount:运行时挂载实例,绑定某个空间根节点。FileNode:文件或目录节点。FileVersion:单文件版本。Checkpoint:某个时刻的空间快照。VersionTree:用于快速路径解析和一致性判断的内存树。ShadowDir:不上云的本地目录。FileEvent:文件生命周期事件。RuntimeFileAsset:文件与业务任务的关系。
9.4 Space / Mount / File Node / Version / Checkpoint
Space
Space 表示一棵文件树的业务归属。
建议类型:
USER_SPACE:用户个人空间。PROJECT_SPACE:项目共享空间。CONVERSATION_SPACE:会话空间。TASK_SPACE:任务临时空间。TEAM_SPACE:团队共享空间。
Mount
Mount 表示运行时将某个 Space 挂载到某个 workspace 路径。
挂载参数包括:
spaceType。rootFileId。mountPath。tenantCode。userId。conversationId。taskId。
Mount 的设计允许沙箱先启动,等任务认领时再动态挂载具体项目空间。
File Node
File Node 表示目录或文件。
字段建议:
fileId。parentId。name。nodeType。mimeType。size。version。objectKey。shadowFlag。deleteFlag。
File Version
File Version 表示单个文件的一次内容版本。
字段建议:
versionId。fileId。versionNo。objectKey。contentHash。size。createdByAgent。createdByTaskId。createTime。
Checkpoint
Checkpoint 表示一组文件节点在某个时间点的快照。
适用场景:
- Agent 执行前自动 checkpoint。
- 多 Agent 子任务开始前 checkpoint。
- 用户手动保存 checkpoint。
- Reviewer 发现问题后回滚。
Checkpoint 可以支持:
- 后向回滚。
- 前向保留。
- 文件级恢复。
- 目录级恢复。
- 任务级恢复。
9.5 MCP / Shell / FUSE / HTTP File API
AGFS 应提供多种访问入口。
MCP
MCP 入口面向 LLM 和 Agent。
适合能力:
- 列目录。
- 读文件。
- 写文件。
- 搜索文件。
- 创建 checkpoint。
- 恢复版本。
Shell
Shell 入口面向运行时和高级用户。
适合场景:
cat。ls。grep。python script.py。npm build。
FUSE
FUSE 入口用于让现成工具透明访问 AGFS。
适合场景:
- npm。
- git。
- Python。
- Office 文档转换。
- 数据处理工具。
HTTP File API
HTTP File API 是 AGFS Server 的统一协议层。
所有入口最终应归一到同一套 API,避免 MCP、Shell、FUSE 各自实现业务逻辑。
9.6 Version Tree
Version Tree 用于将高频路径解析从网络操作变为内存操作。
Agent 执行任务时会频繁调用:
ls。stat。open。read。grep。
如果每次都查询远程元数据服务,性能会不可接受。
Version Tree 的基本思想:
- 每个节点有单调递增版本号。
- Server 内存维护当前文件树。
- 后台定期检查根节点版本。
- 远端版本更新时增量或局部刷新。
- 本地写操作期间通过操作计数器避免竞态刷新。
目标是让大部分路径解析走本地内存,同时保证多 Agent 协作时不会长期读到旧状态。
9.7 Close-to-Open 一致性
多 Agent 共享文件时,一致性非常重要。
默认建议采用 close-to-open 一致性:
- 一个 Agent 写入并 close 文件后。
- 另一个 Agent reopen 文件时需要校验版本。
- 同一个文件句柄内的多次读写不重复校验。
这样可以在性能和正确性之间取得平衡。
一致性策略建议支持两档:
| 策略 | 适用场景 | 特点 |
|---|---|---|
CTO |
多 Agent 互读产物 | open 时校验版本,默认推荐 |
RELAXED |
延迟优先场景 | 依赖后台同步,可能短暂读旧 |
9.8 Shadow Dir
Shadow Dir 用于处理不应进入云端主树的本地目录。
典型目录:
node_modules。.venv。vendor。.cache。- 构建临时目录。
这些目录特点:
- 文件数量巨大。
- 可重建。
- 只对当前运行环境有意义。
- 上传云端价值低。
- 会拖慢元数据和对象存储。
Shadow Dir 的策略是:
- 在
mkdir时识别特定 basename。 - 在元数据树中标记为 shadow。
- 后续子树读写重定向到客户端本地路径。
- 不写入对象存储。
- 不进入 AGFS 主版本树。
9.9 文件版本与快照回滚
AGFS 需要同时支持单文件版本和 workspace checkpoint。
单文件版本适合:
- 恢复某个文件的历史版本。
- 对比文件修改。
- 找回误覆盖内容。
Checkpoint 适合:
- 回滚整个任务期间的变更。
- 回滚某个目录。
- 多 Agent 子任务失败后撤回。
- 用户明确要求“回到刚才那个版本”。
任务执行前建议自动创建 checkpoint。
当任务成功且用户接受结果时,可以保留 forward 状态;当任务失败或用户不满意时,可以 rollback 到执行前。
9.10 多 Agent 共享工作区
AGFS 是多 Agent 协作的文件底座。
多 Agent 共享工作区需要满足:
- 多个 runtime 实例挂载同一个
project_space。 - 一个 Agent 写入的文件,其他 Agent 可及时读取。
- 文件修改事件可被记录。
- 子任务产物可被 Reviewer 和 Synthesizer 使用。
- 每个 Agent 的修改可以通过 checkpoint 区分和回滚。
示例:
Researcher 写入 /workspace/research/context.md
DataAgent 写入 /workspace/data/analysis.xlsx
Writer 读取上述文件并写入 /workspace/output/report.md
Reviewer 读取 report.md 并写入 /workspace/review/comments.md
Synthesizer 汇总最终输出
9.11 文件血缘与知识候选沉淀
AGFS 文件需要和业务对象建立关系。
建议记录:
- 文件由哪个任务生成。
- 文件由哪个 Task Step 生成。
- 文件由哪个 Agent 角色生成。
- 文件由哪个 Skill 生成。
- 文件读取了哪些输入文件。
- 文件是否被用户下载或采纳。
- 文件是否被多次复用。
- 文件是否被标记为知识候选。
文件沉淀路径:
EPHEMERAL
  -> FINAL_ARTIFACT
  -> CONTEXT_FILE
  -> KNOWLEDGE_CANDIDATE
  -> KNOWLEDGE_ASSET
注意:
AGFS 文件进入 KNOWLEDGE_CANDIDATE 后,并不意味着自动进入 OpenViking 知识库。它应先进入知识中心草稿,经过人工或规则审核后,再进入组织知识治理流程。
10. 多智能体协作框架
Multi-Agent Framework 描述 FlowNex 如何从单 Agent 执行演进为多 Agent 协作。

多 Agent 协作的目标不是让多个 Agent 同时聊天,而是让复杂任务可以被拆解、分派、执行、审查、合并和回滚。
10.1 多 Agent 协作目标
多 Agent 协作主要解决以下问题:
- 单 Agent 难以稳定完成长链路复杂任务。
- 不同子任务需要不同专业能力。
- 执行、审查、汇总应由不同角色承担。
- 多个任务产物需要共享文件空间。
- 失败后需要局部重试或回滚。
典型复杂任务:
基于客户资料、项目文档、最近会议纪要和销售数据,
生成一份客户经营分析报告,
并检查是否符合公司模板和风险规范。
这个任务可以拆为资料检索、数据分析、报告撰写、风险审查和最终汇总。每个环节由不同 Agent 角色承担更合理。
10.2 角色模型:Planner / Researcher / Executor / Reviewer / Synthesizer
第一期建议采用受控角色模型。
Planner
负责:
- 理解用户目标。
- 拆解任务。
- 生成 Task Graph。
- 分配 Agent 角色。
- 判断依赖顺序。
- 定义最终交付标准。
Researcher
负责:
- 检索知识库。
- 搜索外部资料。
- 阅读 AGFS 文件。
- 汇总上下文。
- 输出结构化资料包。
Executor
负责:
- 调用 Tool。
- 运行脚本。
- 处理文件。
- 生成中间产物。
- 输出阶段性结果。
Reviewer
负责:
- 检查事实依据。
- 检查格式要求。
- 检查风险和遗漏。
- 对产物提出修改建议。
- 决定是否需要回滚或重试。
Synthesizer
负责:
- 汇总各子任务结果。
- 消除冲突。
- 统一表达风格。
- 生成最终回复或最终交付文件。
10.3 Task Graph
Task Graph 是多 Agent 协作的核心数据结构。
它描述:
- 用户目标。
- 子任务节点。
- 节点依赖。
- 节点负责 Agent。
- 节点输入。
- 节点输出。
- 节点状态。
- 失败策略。
建议模型:
AgentTaskGraph
  graphId
  tenantCode
  conversationId
  rootTaskId
  status
  createdBy
  createTime

AgentTaskNode
  nodeId
  graphId
  parentNodeId
  roleType
  skillCodes
  toolCodes
  knowledgeAccess
  agfsCheckpointId
  status
  inputManifest
  outputManifest

AgentTaskEdge
  edgeId
  graphId
  fromNodeId
  toNodeId
  dependencyType
Task Graph 不应第一期设计得过于自由。推荐先支持 DAG,避免循环依赖。
10.4 子任务分发与回收
Planner 生成 Task Graph 后,control-center 可以按依赖关系分发子任务。
子任务分发流程:
flowchart LR
    A["Planner 生成 Task Graph"] --> B["control-center 创建子 Task"]
    B --> C["agent-runtime-gateway 分配 runtime"]
    C --> D["share-harness 执行子任务"]
    D --> E["回传子任务结果"]
    E --> F["更新 Task Graph 节点状态"]
    F --> G["触发后继节点"]
子任务输出应结构化写入:
- Task Step。
- AGFS 文件。
- output manifest。
- runtime event。
- 节点状态。
10.5 Agent Handoff
Agent Handoff 表示一个 Agent 将上下文、产物或问题交给另一个 Agent。
Handoff 不是简单转发自然语言,而应包含结构化上下文:
- 来源节点。
- 目标节点。
- 交接原因。
- 输入文件。
- 输出文件。
- 已完成结论。
- 待解决问题。
- 风险提示。
示例:
{
  "fromRole": "Researcher",
  "toRole": "Writer",
  "reason": "research_completed",
  "files": [
    "/workspace/research/customer-context.md",
    "/workspace/research/policy-evidence.md"
  ],
  "summary": "已完成客户背景和政策依据整理,待生成报告正文。"
}
10.6 共享知识与共享文件
多 Agent 协作需要两类共享上下文:
- 共享知识。
- 共享文件。
共享知识由 Knowledge System 提供。
每个子任务都应继承或收窄根任务的 knowledgeAccess,不能绕过用户和 Skill 权限。
共享文件由 AGFS 提供。
每个子任务可以读写同一个 project_space 或 task_space,但应通过 checkpoint 区分不同 Agent 的修改。
建议规则:
- 根任务创建 AGFS checkpoint。
- 每个子任务开始前创建子 checkpoint。
- 子任务产物写入约定目录。
- Reviewer 可以基于 checkpoint 回滚某个子任务。
- Synthesizer 只读取已通过审查的文件。
10.7 审阅、合并与最终输出
多 Agent 结果不能简单拼接。
Reviewer 和 Synthesizer 需要完成:
- 事实核对。
- 格式检查。
- 冲突消解。
- 质量评分。
- 引用整理。
- 最终输出生成。
最终输出可以是:
- 普通回复。
- Markdown 报告。
- Excel 文件。
- PPT。
- 飞书文档。
- AGFS 文件路径。
最终输出应关联:
- 来源子任务。
- 来源文件。
- 来源知识。
- Reviewer 结论。
- 用户反馈。
10.8 失败恢复与回滚
多 Agent 协作中,失败恢复比单 Agent 更重要。
失败类型包括:
- 子任务超时。
- Tool 调用失败。
- 知识召回不足。
- 文件写入冲突。
- Reviewer 不通过。
- Synthesizer 合并失败。
恢复策略:
- 重试当前节点。
- 换 Agent 或模型重试。
- 降级使用更少上下文。
- 回滚当前节点 checkpoint。
- 跳过非关键节点。
- 请求人工介入。
所有失败恢复动作都应写入 Task Graph 事件,便于审计和复盘。
11. 部署指南
Deployment 描述 FlowNex 的部署组件、外部依赖和推荐部署方式。
11.1 环境依赖
FlowNex 依赖以下基础环境:
- Java 21。
- Spring Boot 3.3.x。
- Python 3.11+。
- MySQL。
- Redis。
- RocketMQ。
- OSS / S3 兼容对象存储。
- Nacos 或等价注册配置中心。
- OpenViking 知识库服务。
- 后续 AGFS Server 和 AGFS Metadata Service。
11.2 Java 服务部署
Java 服务包括:
ai-claw-gateway。ai-app-runtime-gateway。ai-app-service。control-center。user-domain-service。agent-domain-service。agent-runtime-gateway。xingyun-ai-common公共依赖。
Java 服务推荐按独立应用部署,每个服务拥有独立启动工程和配置。
部署要求:
- 所有服务使用统一 trace 头。
- 所有服务接入统一日志规范。
- Dubbo 服务注册和发现稳定。
- 数据库 migration 可重复执行。
- 配置按环境隔离。
11.3 share-harness 部署
share-harness 是 Python / FastAPI Agent Runtime。
部署时需要配置:
- 模型访问凭证。
- Runtime 实例注册信息。
- Redis 连接。
- OSS 连接。
- Tool registry。
- Skill root 或 Skill cache。
- 回调地址。
- AGFS mount 配置。
share-harness 应支持多实例水平扩展。
运行时实例需要通过心跳或注册机制被 agent-runtime-gateway 感知。会话绑定后,同一会话的请求优先路由到已绑定实例。
11.4 agent-runtime-gateway 部署
agent-runtime-gateway 负责 runtime 路由和事件回推。
部署要求:
- 可访问 Redis。
- 可访问 RocketMQ。
- 可访问
share-harness实例。 - 可按来源调用
ai-claw-gateway或ai-app-runtime-gateway的 SSE push 能力。 - 支持运行时实例健康检查。
- 支持会话绑定恢复。
agent-runtime-gateway 不直接访问 MySQL,避免把运行时路由层变成业务领域服务。
11.5 Redis / MySQL / RocketMQ / OSS 依赖
MySQL
用于保存领域数据:
- 用户。
- Agent。
- Conversation。
- Message。
- Task。
- Task Step。
- Skill。
- Knowledge Mapping。
- AGFS Metadata。
Redis
用于保存运行时状态:
- SSE 会话。
- Runtime 实例注册。
- 会话绑定。
- 分布式锁。
- 幂等状态。
- 临时缓存。
RocketMQ
用于异步事件:
- Runtime 回调。
- 任务状态事件。
- 文件事件。
- 知识同步事件。
- 经验沉淀任务。
OSS
用于保存大文件正文:
- 用户附件。
- Agent 输出文件。
- AGFS 文件对象。
- Runtime backup。
11.6 AGFS 服务部署
AGFS 建议拆分为:
- AGFS Server。
- AGFS Metadata Service。
- AGFS FUSE Client。
- AGFS MCP Server。
- Object Storage。
AGFS Server 应尽量无状态,支持水平扩展。
Metadata Service 负责:
- File Node。
- File Version。
- Space。
- Mount。
- Checkpoint。
- Version Tree 持久化。
FUSE Client 可部署在 runtime sandbox 或执行节点内,为现成工具提供透明文件系统访问。
11.7 多实例与扩容
FlowNex 的扩容策略:
ai-claw-gateway按 FlowNex 主站、管理台、飞书渠道连接数和 QPS 扩容。ai-app-runtime-gateway按 AI 应用中心application路由连接数和 QPS 扩容。ai-app-service按 AI 应用交互接口、业务语义接口和业务落库压力扩容。control-center按能力中心 QPS、编排请求、回调压力和能力调用治理压力扩容。agent-domain-service按领域读写压力扩容。agent-runtime-gateway按 runtime 路由和事件压力扩容。share-harness按模型并发和工具执行负载扩容。- AGFS Server 按文件 API QPS 扩容。
- AGFS Metadata Service 按路径解析和版本写入压力扩容。
11.8 灰度发布与回滚
需要支持灰度的对象:
- Java 服务版本。
share-harnessruntime 版本。- Skill 版本。
- Tool 版本。
- 模型配置。
- 知识库配置。
- AGFS 功能开关。
- 多 Agent 策略。
发布前应保证:
- migration 已验证。
- 新旧协议兼容。
- 关键链路有回滚方案。
- runtime 事件兼容。
- 管理台开关可控。
12. 配置说明
Configuration 描述 FlowNex 中需要被配置和治理的核心参数。
12.1 服务配置
服务配置包括:
- 应用名。
- 环境标识。
- 端口。
- Dubbo 配置。
- Nacos 配置。
- Redis 配置。
- MySQL 配置。
- RocketMQ 配置。
- 日志配置。
- trace 配置。
服务配置应按环境隔离:
- local。
- dev。
- test。
- staging。
- prod。
12.2 模型配置
模型配置用于决定 Agent 使用哪个模型以及如何调用。
常见参数:
- provider。
- model name。
- api endpoint。
- credential ref。
- temperature。
- max tokens。
- context window。
- timeout。
- retry。
- fallback model。
模型配置应支持按场景选择。
例如:
- 普通问答使用低成本模型。
- 合同评审使用更高可靠模型。
- 长文档分析使用长上下文模型。
- 多 Agent Planner 使用规划能力更强的模型。
12.3 Runtime 配置
Runtime 配置用于控制 share-harness 的执行策略。
包括:
- 执行模式:
react / plan。 - 最大执行步数。
- 单任务超时。
- Tool 调用超时。
- 文件读取限制。
- 工具输出裁剪限制。
- recent messages 保留策略。
- prompt 预算策略。
- Skill 加载策略。
- Runtime backup 策略。
Runtime 配置应支持租户级、Agent 级和任务类型级覆盖。
12.4 Tool 配置
Tool 配置包括:
- Tool code。
- Tool 名称。
- Tool 描述。
- 入参 schema。
- 权限要求。
- 超时。
- 重试策略。
- 是否允许在当前渠道使用。
- 是否需要用户授权 token。
- 输出裁剪策略。
Tool 配置需要特别关注安全边界。
例如,shell_run、外部 HTTP 调用、飞书审批操作等 Tool 应有更严格的授权和审计。
12.5 Skill 配置
Skill 配置包括:
- Skill 基础信息。
- Skill 分类。
- Skill 内容。
- Skill 版本。
- Skill 安装范围。
- Skill 预装范围。
- Skill 启停状态。
- Skill 依赖 Tool。
- Skill 绑定知识库。
- Skill 评测和灰度配置。
Skill 配置变更应进入审核流程,尤其是企业级和平台级 Skill。
12.6 知识库配置
知识库配置包括:
- Provider。
providerResourceId。- 本地资产名称。
- 本地资产编码。
- 可见范围。
- 检索 topK。
- 相似度阈值。
- 引用展示策略。
- 超时。
- 降级策略。
知识库配置必须避免泄露 Provider 凭证。运行时只应拿到经过裁剪的 knowledgeAccess。
12.7 AGFS 配置
AGFS 配置包括:
- AGFS Server endpoint。
- Metadata Service endpoint。
- Object Storage bucket。
- FUSE mount path。
- 默认一致性策略。
- Version Tree 同步间隔。
- Multipart 分片大小。
- Multipart 并发度。
- Shadow Dir basename 列表。
- Checkpoint 策略。
- 文件大小限制。
- 文件版本保留策略。
AGFS 配置需要按任务场景调优。例如数据分析任务可能需要更大的文件限制,代码编译任务需要更激进的 Shadow Dir 策略。
12.8 渠道配置
渠道配置包括:
- Web。
- 飞书 / Lark。
- 后续企业微信、钉钉或内部系统。
渠道配置需要管理:
- 应用 ID。
- 应用 Secret。
- 回调地址。
- 用户身份映射。
- 消息格式限制。
- 附件处理策略。
- 权限范围。
- 输出策略。
12.9 安全配置
安全配置包括:
- 身份认证。
- 网关鉴权。
- Dubbo attachment 用户上下文。
- trace 头。
- 凭证引用。
- 敏感字段脱敏。
- Tool allowlist。
- 文件访问策略。
- 知识库访问策略。
- 审计日志开关。
安全配置应遵守最小权限原则。
13. 可观测性
Observability 描述 FlowNex 如何观测一次 Agent 任务从入口、编排、运行时、工具、知识、文件到最终结果的完整链路。
企业级 Agent 平台必须具备可解释和可排障能力。一次 Agent 回答不应只是“模型说了什么”,还应能回答“系统为什么这样做”。
13.1 日志规范
日志应覆盖所有核心服务:
ai-claw-gateway。ai-app-runtime-gateway。ai-app-service。control-center。agent-domain-service。user-domain-service。agent-runtime-gateway。share-harness。- AGFS Server。
- AGFS Metadata Service。
日志字段建议统一:
traceId。tenantCode。userId。conversationId。taskId。messageId。runtimeInstanceId。eventType。errorCode。durationMs。capabilityCode。providerCode。adapterCode。
日志级别建议:
INFO:关键业务事件。WARN:可降级异常、重试、权限裁剪、超时。ERROR:任务失败、状态不一致、数据持久化失败。DEBUG:开发环境详细上下文。
13.2 Trace 链路
Trace 用于串联跨服务请求。
核心 trace 头:
X-Trace-Id。X-User-Id。- 租户标识。
- Dubbo attachment 中的 trace 和 user 上下文。
一轮任务至少应串联:
ai-claw-gateway main request / ai-app-runtime-gateway application request
  -> control-center main interaction / ai-app-service application interaction
  -> control-center create task or invoke capability
  -> agent-domain-service persistence
  -> agent-runtime-gateway infer
  -> share-harness run
  -> runtime callback
  -> SSE push
Trace 不只用于技术排障,也用于审计和任务回放。
13.3 Runtime 事件
Runtime 事件是观察 Agent 执行过程的核心。
建议事件类型:
task.started。planner.started。planner.completed。skill.recalled。skill.loaded。tool.started。tool.completed。knowledge.search.started。knowledge.search.completed。file.created。file.updated。checkpoint.created。checkpoint.rollback。task.completed。task.failed。
Runtime 事件有两类消费者:
- SSE 展示。
- 后台持久化和指标统计。
13.4 任务执行指标
任务执行指标用于观察 Agent 系统整体健康度。
建议指标:
- 任务总数。
- 成功任务数。
- 失败任务数。
- 取消任务数。
- 平均任务耗时。
- P95 / P99 任务耗时。
- 平均 Task Step 数。
- 平均模型调用次数。
- 平均工具调用次数。
- 平均 token 消耗。
按维度聚合:
- 租户。
- 用户。
- Agent。
- Skill。
- 渠道。
- 模型。
- 任务类型。
13.5 知识命中指标
知识命中指标用于判断知识库是否有效。
建议指标:
- 知识检索次数。
- 知识命中次数。
- 无命中次数。
- 检索超时次数。
- 平均检索耗时。
- 命中文档数。
- 最终引用片段数。
- 因权限裁剪的知识数。
- 因 Skill
FORBIDDEN裁剪的知识数。 REQUIRED知识缺失次数。
这些指标可以帮助管理员发现:
- 哪些知识库没人用。
- 哪些知识库经常无召回。
- 哪些 Skill 绑定知识过窄。
- 哪些知识权限配置不合理。
- 哪些知识需要更新或归档。
13.6 Skill 使用指标
Skill 使用指标用于运营企业 Agent 能力。
建议指标:
- Skill 曝光次数。
- Skill 命中次数。
- Skill 实际使用次数。
- Skill 任务成功率。
- Skill 任务失败率。
- 平均执行耗时。
- 平均 token 消耗。
- 关联知识命中率。
- 用户点赞率。
- 用户点踩率。
这些指标可以指导:
- 哪些 Skill 值得推广。
- 哪些 Skill 需要下线。
- 哪些 Skill 需要补充知识。
- 哪些 Skill 需要优化提示词或工具链。
13.7 AGFS 文件指标
AGFS 指标用于观察 Agent 文件系统健康度。
建议指标:
- 文件读次数。
- 文件写次数。
- 目录查询次数。
- 文件版本创建次数。
- checkpoint 创建次数。
- rollback 次数。
- Shadow Dir 命中次数。
- Version Tree 命中率。
- Metadata Service QPS。
- Object Storage 上传下载耗时。
- FUSE mount 成功率。
- 多 Agent 文件同步延迟。
AGFS 指标直接影响 Agent 任务体验。目录查询慢、文件同步延迟高、checkpoint 失败都会影响多 Agent 协作质量。
13.8 多 Agent 协作指标
多 Agent 指标用于观察复杂任务协作质量。
建议指标:
- Task Graph 创建数。
- 平均子任务数。
- 子任务成功率。
- 子任务重试次数。
- Handoff 次数。
- Reviewer 驳回次数。
- Synthesizer 合并失败次数。
- checkpoint rollback 次数。
- 多 Agent 总耗时。
- 多 Agent 相比单 Agent 的成功率提升。
这些指标用于判断多 Agent 是否真的提升了复杂任务完成质量,而不是增加系统复杂度。
13.8.1 接入能力的调用观测与质量评估
业务线 AI 应用和原子化 AI 能力接入后,FlowNex 需要新增按能力维度的观测体系。
能力调用 Trace 至少应覆盖:
capabilityCode。capabilityVersion。providerCode。adapterCode。tenantCode。agentCode。skillCode。toolCode。- 输入 Schema 版本。
- 输出 Schema 版本。
- 调用状态。
- 错误码和错误映射。
- 耗时。
- 重试次数。
- 降级策略。
- 成本或计量信息。
能力运营指标建议按以下维度聚合:
| 维度 | 指标 |
|---|---|
| 业务线 | 调用量、成功率、P95 耗时、错误分布、成本 |
| 能力 | 调用量、成功率、平均耗时、Schema 失败率、降级次数 |
| Provider | 可用率、超时率、重试次数、SLA 达成率 |
| 租户 | 开通能力数、使用活跃度、调用成本、失败 Top 能力 |
| Agent / Skill | 调用了哪些原子能力、对任务成功率的贡献、失败原因 |
对于高价值或高风险能力,还应接入自动回归测试:
- 维护标准输入输出样例。
- 在 Provider 或 Adapter 变更后自动回放。
- 对关键字段准确率、格式稳定性、耗时和错误率做评估。
- 将回归结果作为能力发布、灰度和回滚依据。
这样可以避免业务线能力“接进来了但不可运营”,也能帮助平台判断某个 Agent 失败到底来自模型、Skill、知识、Tool 还是外部 Capability。
13.8.2 Coze Loop 观测落地形态
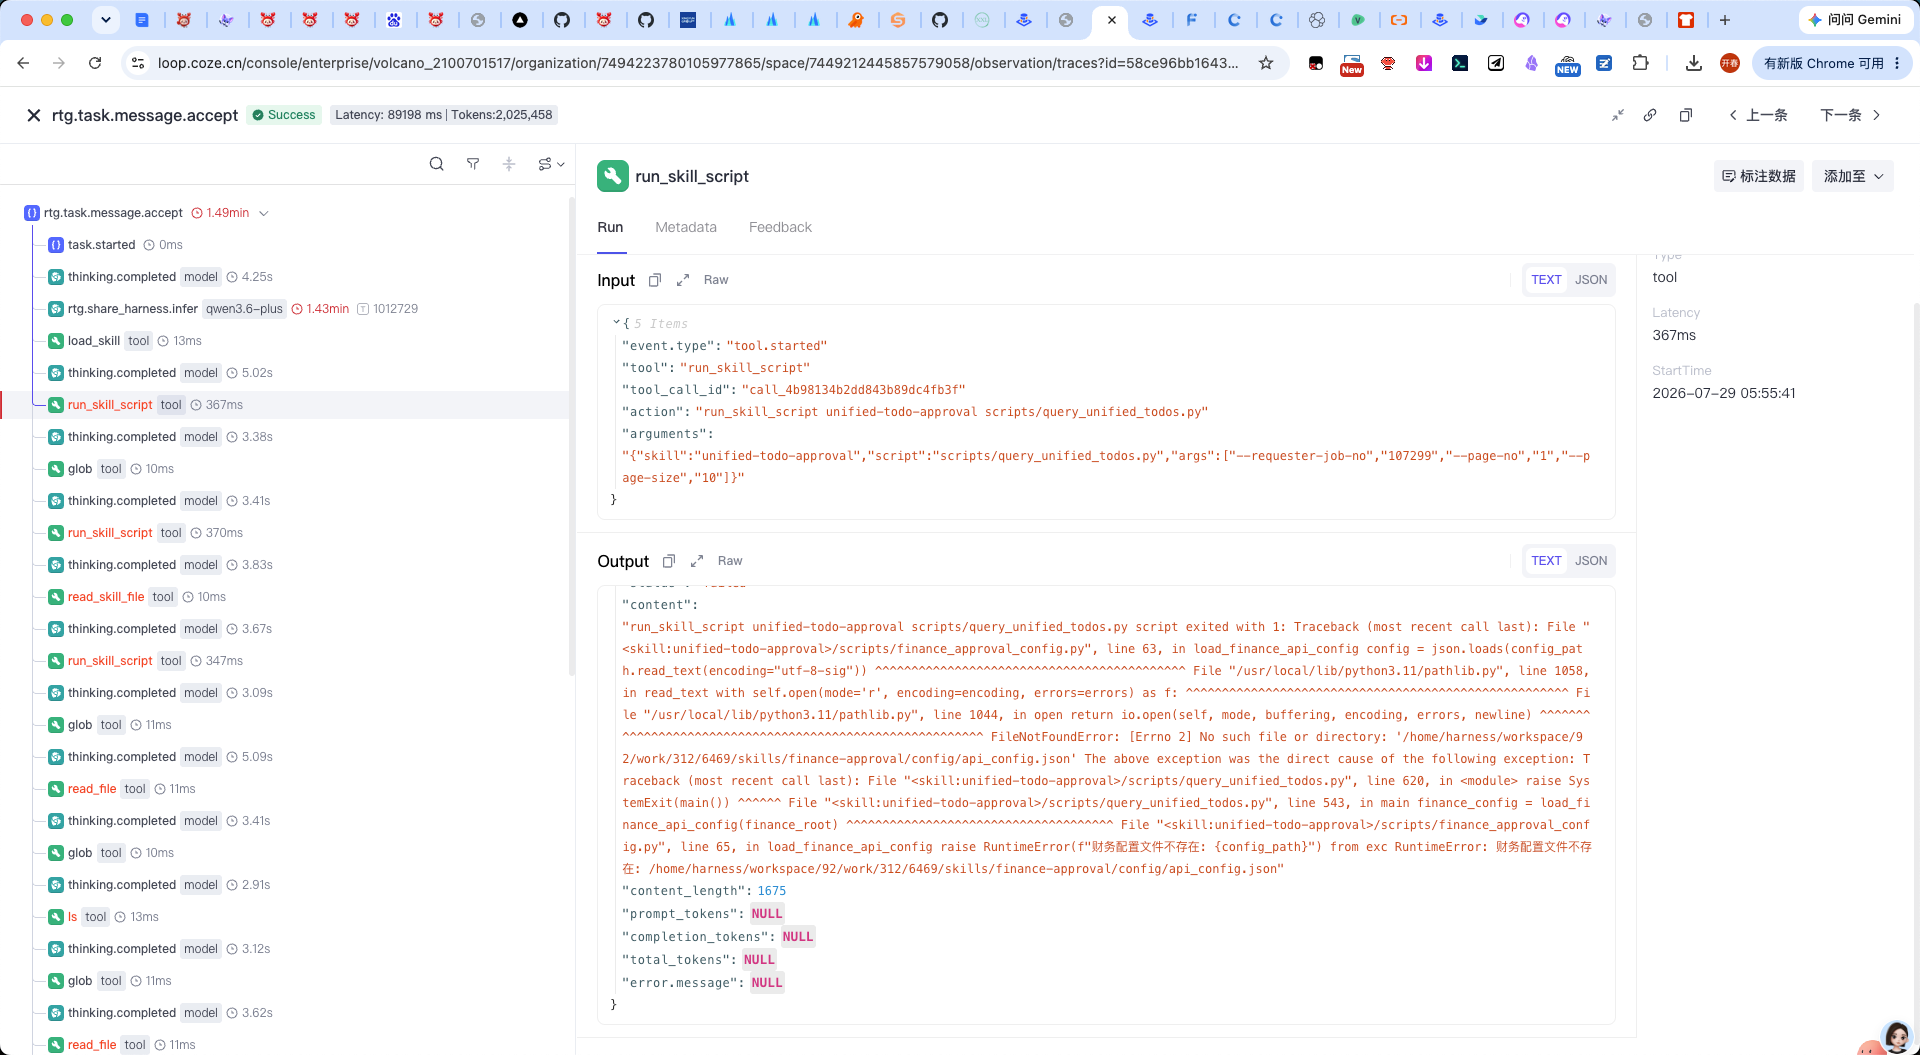
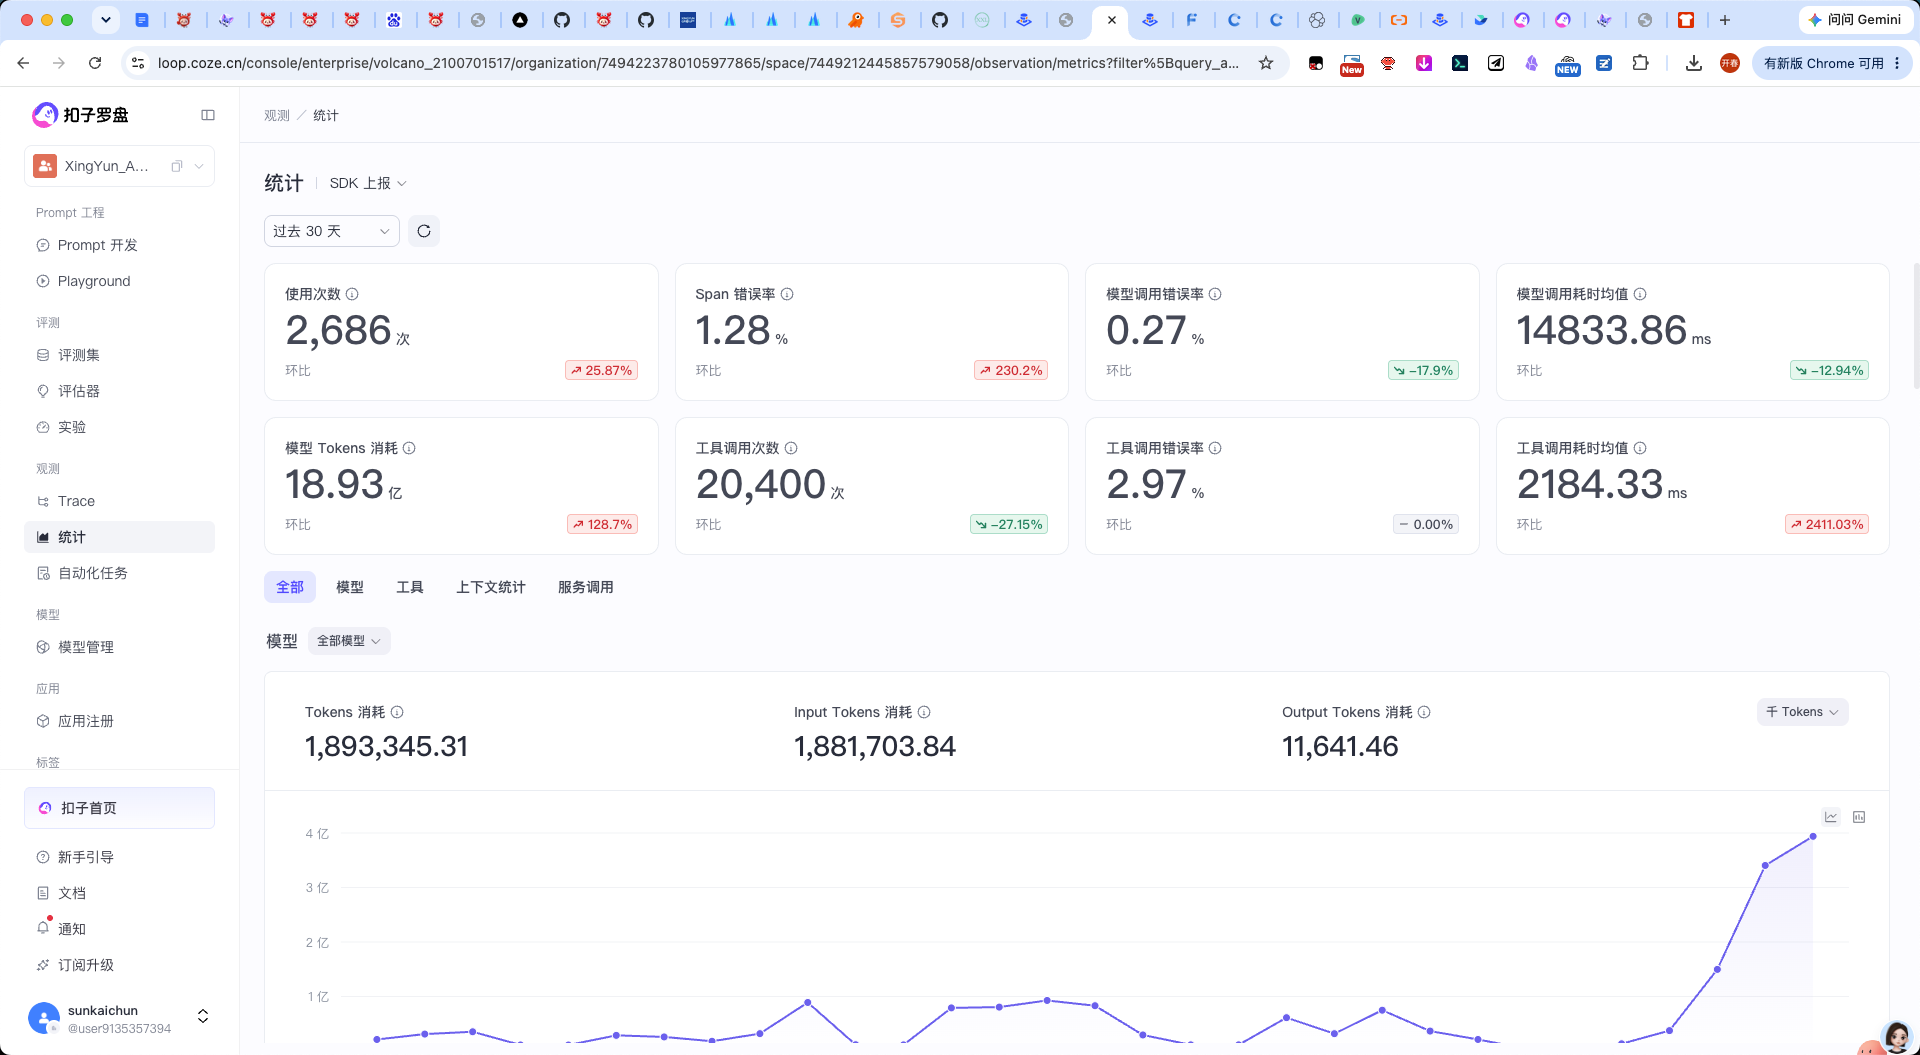
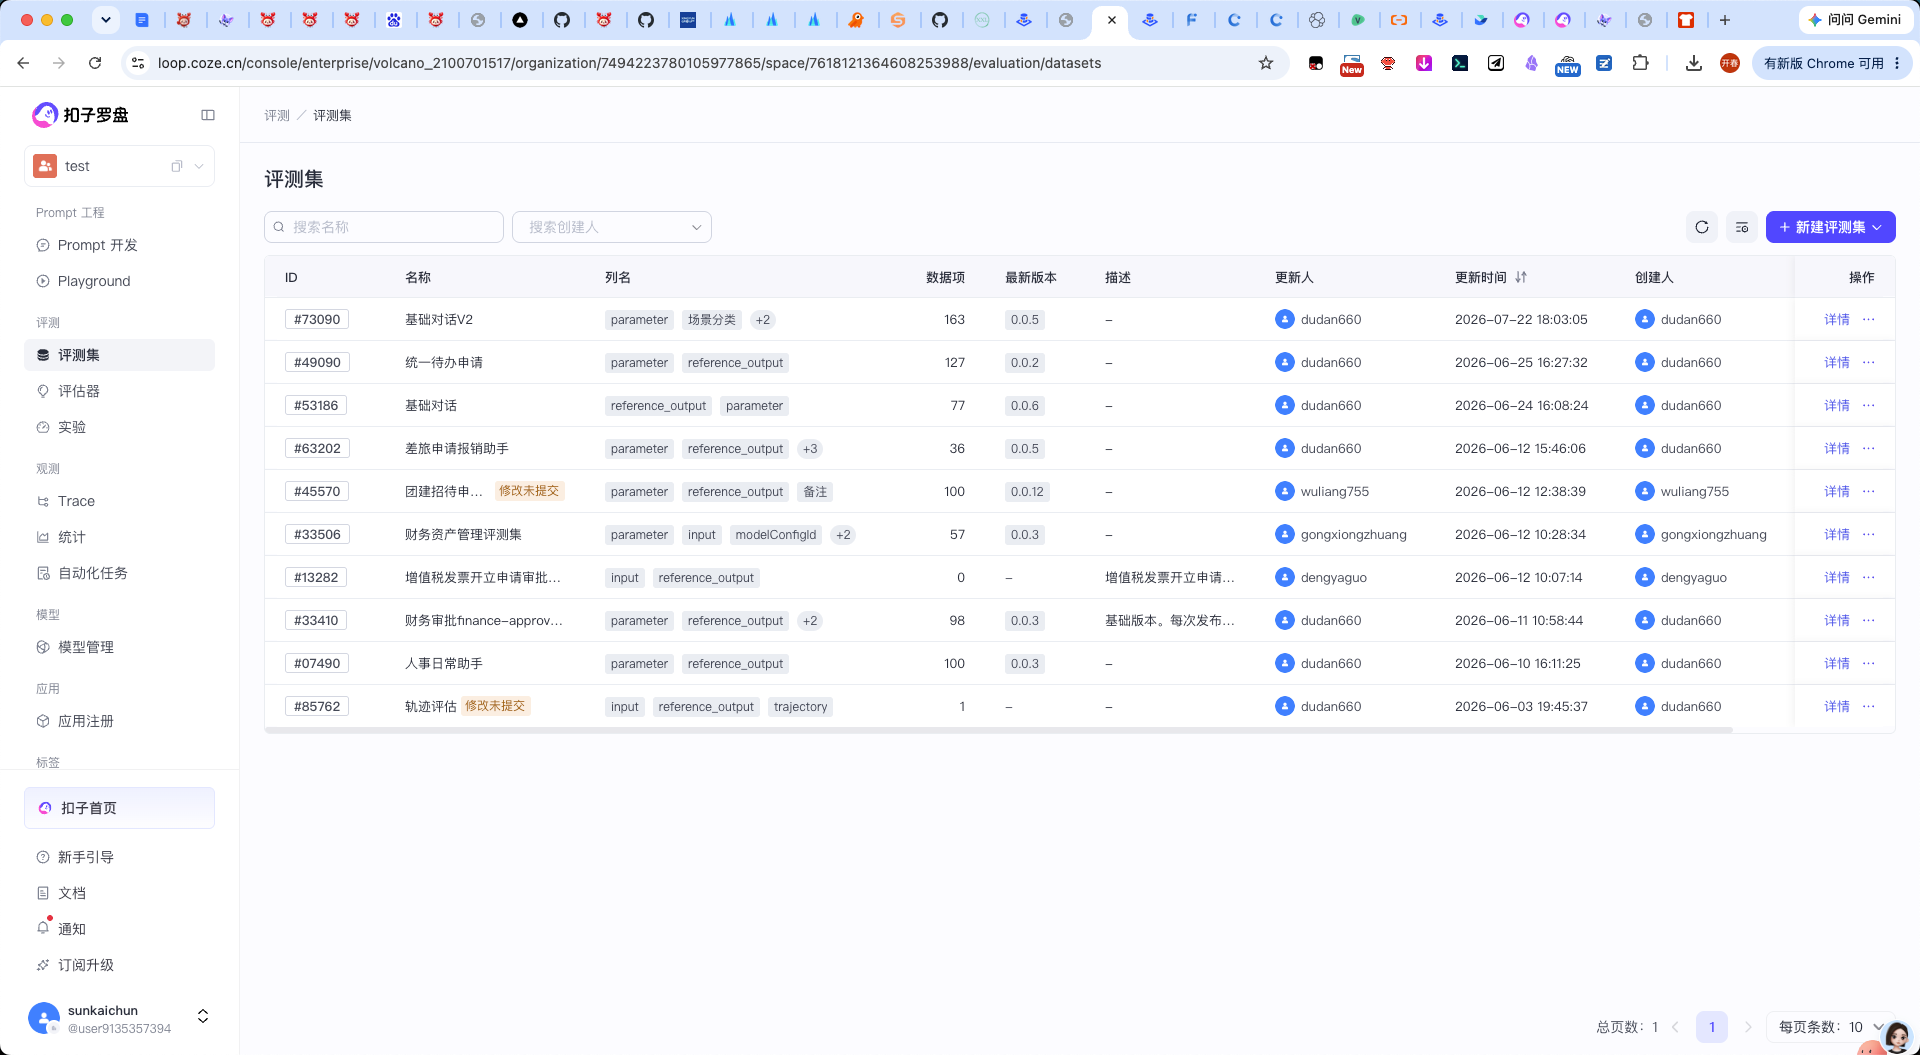
FlowNex 在线运行观测可以结合 Coze Loop 产品落地,重点覆盖三类能力:
- 线上运行日志查询:通过
traceId按入口串联ai-claw-gateway或ai-app-runtime-gateway,并继续关联ai-app-service、control-center、agent-runtime-gateway、share-harness和 Provider 调用日志。 - 监控统计:按应用、租户、能力、Provider、模型、Agent、Skill 统计调用量、成功率、耗时、错误分布和成本。
- 自动回归测试:沉淀高价值任务和能力调用样例,在 Prompt、Skill、Provider Adapter 或模型配置变更后自动回放,辅助发布验收和回滚决策。
Coze Loop 观测闭环
将生产 Trace、指标看板和评测数据集组织成一条持续改进链路:线上问题可定位、能力质量可量化、发布变更可回归。
13.9 告警与排障
建议配置告警:
- Runtime 实例不可用。
- SSE 连接异常升高。
- 任务失败率异常。
- 模型调用超时。
- Tool 调用失败率异常。
- 知识检索超时。
- AGFS Metadata Service 延迟异常。
- AGFS checkpoint 失败。
- RocketMQ 消费堆积。
- MySQL 慢查询。
排障入口应支持按以下字段检索:
traceId。taskId。conversationId。messageId。userId。skillCode。knowledgeAssetId。agfsFileId。
14. 接口参考
API Reference 描述 FlowNex 对外和内部主要 API 分类。具体字段以各服务 client DTO 和 OpenAPI 文档为准,本章先定义接口边界和职责。
14.1 Conversation API
Conversation API 用于管理会话。
典型能力:
- 创建会话。
- 查询会话列表。
- 查询会话详情。
- 删除会话。
- 更新会话标题或配置。
- 查询会话上下文。
主要消费者:
- Web 客户端。
- 管理台。
- 渠道入站编排。
14.2 Task API
Task API 用于管理任务。
典型能力:
- 创建任务。
- 查询任务状态。
- 查询任务步骤。
- 取消任务。
- 更新任务结果。
- 查询任务文件。
- 查询任务回放。
Task API 是连接对话、runtime 和审计的核心 API。
14.3 Message API
Message API 用于管理用户消息和 Agent 回复。
典型能力:
- 创建用户消息。
- 创建 Agent 回复。
- 查询消息列表。
- 查询消息详情。
- 写入消息状态。
- 写入用户反馈。
- 关联消息附件。
Message API 中的 bizFeatures 可保存本轮业务扩展信息,例如知识库选择、反馈摘要、HITL 表单等。
14.4 Skill API
Skill API 用于管理 Skill。
典型能力:
- 查询 Skill 市场。
- 查询我的 Skill。
- 创建 Skill 草稿。
- 更新 Skill 草稿。
- 提交审核。
- 审核通过或拒绝。
- 安装 Skill。
- 启用或停用 Skill。
- 配置 Skill 预装。
- 查询 Skill 使用情况。
后续应增加:
- Skill 版本 API。
- Skill 评测 API。
- Skill 灰度 API。
- Skill 知识绑定 API。
14.5 Knowledge API
Knowledge API 用于知识库查询、映射和检索。
普通用户能力:
- 查询我可访问的知识库。
- 发起知识检索。
- 查询知识引用。
管理员能力:
- 创建本地知识资产映射。
- 更新知识资产状态。
- 配置知识可见范围。
- 查询知识命中统计。
- 管理 Skill 与知识绑定。
运行时能力:
- 使用
knowledgeAccess发起限定范围检索。 - 回传知识命中轨迹。
14.6 Runtime API
Runtime API 连接 agent-runtime-gateway 和 share-harness。
典型能力:
- 初始化会话。
- 发起 infer。
- 变更模型。
- 变更 Agent 风格。
- 查询 runtime 健康状态。
- 接收 runtime 事件。
Runtime 请求应包含:
conversationId。taskId。message。files。toolCodes。skillCodes。knowledgeAccess。channelType。messageBusinessType。- 必要的用户访问 token。
14.7 AGFS API
AGFS API 用于文件系统访问和管理。
核心 API:
- 创建 Space。
- 创建 Mount。
- 查询文件状态。
- 读取文件。
- 写入文件。
- 查询目录。
- 删除文件。
- 创建 checkpoint。
- 回滚 checkpoint。
- 查询文件版本。
- 恢复文件版本。
AGFS API 应同时服务 MCP、Shell、FUSE 和业务管理台。
14.8 Admin API
Admin API 面向管理员。
典型能力:
- 用户管理。
- 角色管理。
- 权限管理。
- Skill 审核。
- 知识库管理。
- 能力包管理。
- 模型配置。
- Runtime 配置。
- 运营报表。
- 审计查询。
Admin API 必须有严格权限控制和审计日志。
14.9 Callback API
Callback API 用于 runtime 和异步系统回调业务层。
典型回调:
- 任务开始。
- 任务进度。
- Task Step 创建或更新。
- 文件产物生成。
- 任务完成。
- 任务失败。
- 知识命中回传。
- AGFS 文件事件。
- 多 Agent 子任务事件。
Callback API 应保证幂等,避免 runtime 重试导致重复写入。
14.10 Capability API
Capability API 用于业务线 AI 应用和原子化 AI 能力接入 FlowNex 后的统一注册、授权、调用和观测。
管理侧能力:
- 注册 Capability。
- 更新 Capability 元数据。
- 管理 Capability 版本。
- 定义输入输出 Schema。
- 绑定 Provider。
- 配置 Provider Adapter。
- 配置租户、部门、角色可见范围。
- 配置限流、超时、重试和降级策略。
- 查询能力调用统计。
- 查询能力回归测试结果。
运行时能力:
- 查询本轮可用 Capability 快照。
- 发起 Capability 调用。
- 查询调用状态。
- 回传调用 Trace。
- 回传错误映射和降级结果。
典型调用请求:
{
  "traceId": "trace-001",
  "tenantCode": "xy",
  "taskId": "task-10001",
  "capabilityCode": "invoice_ocr_extract",
  "capabilityVersion": "1.0.0",
  "providerCode": "finance_ai",
  "input": {
    "fileId": "agfs://space/file-node"
  }
}
典型返回:
{
  "success": true,
  "capabilityCode": "invoice_ocr_extract",
  "providerCode": "finance_ai",
  "output": {
    "invoiceNo": "12345678",
    "amount": "1024.00"
  },
  "durationMs": 860,
  "trace": {
    "adapterCode": "finance_ai_http_adapter",
    "retryCount": 0,
    "schemaVersion": "1.0.0"
  }
}
Capability API 的关键要求:
- 所有调用必须绑定
tenantCode、taskId和traceId。 - runtime 不直接持有 Provider 密钥。
- 输入输出必须符合 Schema。
- 错误码必须映射为平台统一错误。
- 高风险能力需要支持 HITL 或二次确认。
- 调用记录必须进入任务轨迹和审计日志。
15. 开发者指南
Developer Guide 面向 FlowNex 的平台开发者和扩展开发者。
15.1 本地开发环境
本地开发通常需要启动:
- MySQL。
- Redis。
- RocketMQ。
- Nacos。
agent-domain-service。user-domain-service。ai-claw-gateway。ai-app-runtime-gateway。ai-app-service。control-center。agent-runtime-gateway。share-harness。- 前端应用。
开发建议:
- 优先阅读根目录
README.md理解模块边界。 - 每个 Java 服务独立启动。
- Python runtime 单独管理依赖。
- migration 先在测试库验证。
- 修改跨服务 DTO 时同步更新调用方测试。
15.2 代码仓模块说明
核心模块:
ai-claw-gateway:FlowNex 主站网关,负责 AI 应用入口之外的对话、管理台、Skill、知识库、任务中心和飞书等交互接入。ai-app-runtime-gateway:AI 应用中心专用接入网关,负责application前缀路由和 AI 应用前端连接承接。ai-app-service:AI 应用层聚合服务,负责应用交互接口、业务语义接口和业务数据落库。control-center:能力中心和编排协同服务,内部实现 Capability Gateway、Capability Registry、Provider Adapter 等能力治理模块。user-domain-service:用户域。agent-domain-service:Agent、会话、消息、任务、Skill 等领域。agent-runtime-gateway:运行时路由和事件回推。share-harness:Python Agent Runtime。xingyun-ai-common:公共能力。
Java 服务通常采用:
*-client
*-domain
*-application
*-infrastructure
*-server
分层约定:
client:DTO 和 Facade。domain:领域模型和领域能力。application:应用服务和用例编排。infrastructure:数据库、Redis、RPC、外部系统适配。server:启动和配置装配。
15.3 新增一个 Tool
新增 Tool 的推荐步骤:
- 明确 Tool 的动作边界。
- 定义 Tool code。
- 定义入参 schema。
- 定义输出结构。
- 定义权限要求。
- 在能力注册处注册 Tool。
- 在
control-center或领域服务中配置 Tool 授权。 - 在
share-harness中实现 Tool 调用适配。 - 增加测试。
- 增加审计和错误映射。
Tool 设计原则:
- 入参结构化。
- 输出可裁剪。
- 错误可解释。
- 权限可控制。
- 调用可审计。
15.4 新增一个 Skill
新增 Skill 的推荐步骤:
- 编写 Skill 描述。
- 定义适用场景。
- 定义输入要求。
- 定义执行步骤。
- 定义输出格式。
- 声明建议 Tool。
- 绑定必要知识库。
- 提供示例。
- 提交审核。
- 发布并灰度。
高质量 Skill 应避免:
- 目标含糊。
- 输出格式不稳定。
- 隐含依赖未声明。
- 要求使用未授权 Tool。
- 把大量知识硬编码进 Skill。
15.5 新增一个知识检索 Provider
如果未来需要接入 OpenViking 之外的知识 Provider,应遵守统一适配边界。
新增步骤:
- 定义 Provider code。
- 实现检索 Adapter。
- 实现凭证和 endpoint 配置读取。
- 复用本地
KnowledgeAsset / KnowledgeMapping / KnowledgeAcl。 - 保证检索前权限裁剪。
- 输出统一
KnowledgeSearchResponse。 - 记录统一命中轨迹。
Provider 不应绕过本地权限系统。
15.5.1 新增一个业务线 Capability Provider
业务线 AI 能力接入 FlowNex 时,应以 Capability Provider 的方式接入,而不是让 Skill 或 Tool 直接调用业务线接口。
推荐步骤:
- 明确能力边界,判断是完整 AI 应用、原子能力还是业务系统动作。
- 定义
capabilityCode、版本、负责人和所属业务线。 - 定义输入 Schema、输出 Schema 和示例数据。
- 定义鉴权方式,但只保存凭证引用,不把密钥下发给 runtime。
- 实现 Provider Adapter,完成协议转换、字段映射、错误码映射、超时和重试。
- 在 Capability Registry 登记能力元数据。
- 在管理台配置租户、部门、角色、Agent 或 Skill 的可见范围。
- 将能力包装为 Tool,必要时再封装为 Skill。
- 接入 Trace、Metrics、Audit 和自动回归测试。
- 完成联调、灰度、验收和回滚预案。
Provider Adapter 至少需要处理:
| 能力 | 要求 |
|---|---|
| 鉴权 | 使用平台托管凭证或短期 token,不暴露密钥 |
| Schema 校验 | 调用前校验输入,调用后校验输出 |
| 错误映射 | 将业务线错误码转换为 FlowNex 统一错误 |
| 幂等 | 写操作必须支持幂等键或业务去重 |
| 超时重试 | 明确哪些错误可重试,哪些错误不可重试 |
| 降级 | Provider 不可用时返回可解释降级结果 |
| 审计 | 记录调用主体、能力、输入摘要、输出摘要和结果 |
接入验收建议:
- 能力在目录中可查询。
- 未授权用户无法调用。
- 已授权用户可通过 Agent / Skill 正常调用。
- 调用 Trace 可按
taskId和capabilityCode查询。 - 错误码和异常提示清晰。
- 自动回归样例通过。
- 运营报表能看到调用量、成功率、耗时和失败原因。
15.6 新增一个 AGFS 插件
AGFS 插件用于扩展文件系统后端或特殊路径行为。
新增插件建议:
- 实现统一
FileSystem接口。 - 支持
Read / Write / ReadDir / Stat / Mkdir / Open / Delete。 - 接入生命周期 Hook。
- 接入权限检查。
- 接入 Version Tree。
- 接入 checkpoint。
- 增加集成测试。
插件不应把业务租户逻辑硬编码到路径解析中。租户和项目隔离应通过 Space、Mount 和 rootFileId 表达。
15.7 新增一个 Runtime 事件
新增 Runtime 事件需要考虑:
- 事件名称。
- 事件 payload。
- 是否展示给用户。
- 是否持久化。
- 是否参与指标。
- 是否需要兼容旧客户端。
- 是否需要进入任务回放。
事件设计应尽量结构化,避免只传自然语言文本。
示例:
{
  "eventType": "knowledge.search.completed",
  "taskId": "10001",
  "providerResourceIds": ["kb_policy"],
  "hitCount": 3,
  "durationMs": 420
}
15.8 测试规范
测试应覆盖:
- 单元测试。
- Facade 契约测试。
- 应用服务测试。
- Mapper 测试。
- Runtime 工具测试。
- API 集成测试。
- 跨服务协议兼容测试。
- AGFS 文件一致性测试。
- 知识权限裁剪测试。
- Skill 绑定知识范围测试。
关键链路必须有回归测试:
- 创建消息和任务。
- 下发 runtime。
- runtime 回调。
- 知识检索。
- Skill 使用。
- 文件产物持久化。
- SSE 推送。
15.9 兼容性与版本策略
跨服务协议需要保持兼容。
变更原则:
- DTO 新增字段优先使用可选字段。
- runtime 请求新增字段应允许旧版本忽略。
- 事件 payload 新增字段不应破坏旧消费者。
- 数据库 migration 应可重复执行或具备保护。
- 新能力通过 feature flag 灰度。
版本对象包括:
- 服务版本。
- Runtime 协议版本。
- Skill 版本。
- Tool 版本。
- Knowledge mapping 版本。
- AGFS 文件版本。
- 多 Agent 策略版本。
16. 安全体系
Security 描述 FlowNex 在身份、租户、权限、知识、工具、文件和审计方面的安全边界。
企业级 Agent 平台的安全目标不是简单限制模型能力,而是确保 Agent 在正确身份、正确权限、正确上下文和正确审计范围内执行任务。
16.1 身份认证
FlowNex 的所有入口都应绑定可信用户身份。
身份来源可以包括:
- Web 登录态。
- 企业 SSO。
- 飞书 / Lark 用户身份。
- 内部业务系统调用身份。
- 管理员服务账号。
身份认证后,需要在请求链路中传递:
tenantCode。userId。traceId。- 渠道类型。
- 必要时传递角色或权限快照。
用户身份不能只停留在网关层。Dubbo、MQ、runtime callback 等内部链路也需要保留足够身份上下文,避免异步处理时丢失审计主体。
16.2 租户隔离
租户隔离是 FlowNex 的基础安全边界。
需要隔离的对象包括:
- 用户。
- Agent。
- Conversation。
- Message。
- Task。
- Skill。
- Tool 授权。
- Knowledge Asset。
- AGFS Space。
- 文件对象。
- 运行时配置。
所有领域表和查询接口都应显式携带 tenantCode。跨租户查询、更新和运行时能力混用应被禁止。
AGFS 中也不应将租户逻辑硬编码到路径字符串,而应通过 Space、Mount、rootFileId 和权限模型实现隔离。
16.3 用户、角色与权限
权限模型建议采用 RBAC 为主,并在关键资源上叠加资产级授权。
权限范围包括:
- 页面访问权限。
- 管理操作权限。
- Skill 使用权限。
- Tool 使用权限。
- 知识库访问权限。
- AGFS 文件访问权限。
- 多 Agent 操作权限。
运行时能力必须从服务端计算,不应相信前端传入的 Skill、Tool 或知识库范围。
用户可见范围应遵守最小权限原则:
- 没有安装或授权的 Skill 不进入本轮
skillCodes。 - 没有授权的 Tool 不进入本轮
toolCodes。 - 没有权限的知识不进入
knowledgeAccess。 - 没有权限的文件不允许 AGFS 读取。
16.4 知识库越权防护
知识库越权是 Agent 平台的高风险问题。
防护原则:
- 检索前裁剪,而不是检索后过滤。
- 运行时只接收可检索资源 ID。
- Provider 凭证不下发给 runtime 和模型。
- 用户手选知识库仍需本地 ACL 校验。
- Skill 绑定知识库不代表用户自动拥有访问权限。
FORBIDDEN绑定范围必须从本轮检索范围中移除。
错误示例:
先用全租户知识库检索,再把用户无权限结果过滤掉。
正确做法:
先计算用户授权范围,再在授权范围内发起检索。
16.5 Tool 执行安全
Tool 是 Agent 执行动作的入口,必须严格治理。
高风险 Tool 包括:
- Shell 执行。
- 外部 HTTP 请求。
- 数据库写操作。
- 飞书审批操作。
- 文件删除。
- AGFS checkpoint rollback。
- 发送消息或邮件。
Tool 安全策略:
- Tool 必须注册。
- Tool 必须有明确入参 schema。
- Tool 必须按用户和租户授权。
- Tool 调用必须记录审计。
- 高风险 Tool 需要 HITL 或二次确认。
- Tool 输出必须裁剪和脱敏。
- Tool 超时和异常需要映射为可解释错误。
16.6 AGFS 文件权限
AGFS 文件权限需要覆盖人和 Agent。
权限维度:
- 租户。
- 用户。
- 角色。
- 部门。
- 项目。
- Agent 角色。
- Task Graph 节点。
- 文件路径。
- 文件标签。
AGFS 权限操作包括:
read。write。delete。list。checkpoint。rollback。share。promote_to_knowledge_candidate。
默认策略:
- 用户只能访问自己授权空间。
- Agent 只能访问当前任务授权空间。
- 子 Agent 默认继承根任务文件权限,但可被进一步收窄。
- rollback 是高风险操作,需要额外权限或任务级授权。
16.7 敏感信息与凭证管理
敏感信息包括:
- 模型 API Key。
- OpenViking Provider 凭证。
- 飞书 App Secret。
- 用户访问 token。
- 数据库连接串。
- 内部系统 token。
- 用户上传敏感文件。
- 知识库中的敏感制度或业务数据。
处理原则:
- 凭证只保存引用,不在日志中打印明文。
- runtime 请求中只传必要的短期 token。
- 模型上下文中不注入凭证明文。
- 日志、事件、错误信息必须脱敏。
- 前端响应不返回 endpointConfig、credentialRef 等内部字段。
- 敏感文件需要文件级权限和审计。
16.7.1 跨业务线能力接入的安全边界
业务线 AI 应用和原子化 AI 能力接入后,FlowNex 会成为跨业务线能力调用入口,因此必须新增能力级安全边界。
核心原则:
- 能力先注册,再调用。
- 授权先计算,再下发。
- 凭证由平台托管,不进入模型上下文。
- 输入输出按 Schema 校验和脱敏。
- 高风险动作必须有人机确认或审批。
- 所有能力调用必须可审计、可追踪、可回放。
能力级权限至少需要覆盖:
| 权限对象 | 说明 |
|---|---|
| 租户 | 哪些租户可开通该能力 |
| 部门 / 角色 | 哪些组织范围可使用该能力 |
| Agent | 哪些 Agent 能力包可注入该能力 |
| Skill | 哪些 Skill 可调用该能力 |
| Tool | 哪些 Tool 映射到该能力 |
| 用户 | 是否存在用户级白名单或黑名单 |
跨业务线数据安全需要关注:
- 输入文件是否允许传给外部 Provider。
- Provider 返回内容是否包含敏感字段。
- 调用摘要是否需要脱敏后进入日志。
- 能力输出是否允许进入模型上下文。
- 能力输出是否允许沉淀为知识候选。
- 业务线 Provider 是否允许保存调用数据。
禁止模式:
Skill 直接读取业务线密钥并调用外部 AI 服务。
推荐模式:
Skill / Tool
  -> Capability Gateway
  -> 平台托管凭证
  -> Provider Adapter
  -> 业务线能力
这样可以保证业务线能力接入后仍然满足租户隔离、最小权限、凭证安全和审计可追踪要求。
16.8 审计与合规
审计日志应记录:
- 谁发起了任务。
- 使用了哪些 Skill。
- 调用了哪些 Tool。
- 检索了哪些知识。
- 读取或修改了哪些文件。
- 是否触发了 checkpoint 或 rollback。
- 是否发送了外部消息。
- 管理员修改了哪些配置。
审计对象包括:
- 普通用户行为。
- 管理员行为。
- Agent 行为。
- Runtime 行为。
- 多 Agent 子任务行为。
审计数据既服务合规,也服务 badcase 复盘和能力演进。
17. 故障排查
Troubleshooting 描述 FlowNex 常见问题的排查思路。
排障时建议优先获取:
traceId。tenantCode。userId。conversationId。taskId。messageId。- 发生时间。
- 渠道类型。
- 用户原始输入。
17.1 对话无响应
可能原因:
- SSE 未建立成功。
control-center创建任务失败。agent-runtime-gateway未找到 runtime 实例。share-harness实例不可用。- 模型调用超时。
- Runtime 事件未正确回推。
排查步骤:
- 查询网关日志,确认请求是否进入。
- 查询
control-center是否创建 Message 和 Task。 - 查询
agent-runtime-gateway会话绑定。 - 查询
share-harnessruntime 日志。 - 查询 SSE push 事件。
- 根据
traceId串联完整链路。
17.2 SSE 断连
可能原因:
- 客户端网络中断。
- 网关连接超时。
- SSE session 丢失。
- runtime 事件推送失败。
- 代理或负载均衡超时配置不合理。
排查步骤:
- 按入口查询
ai-claw-gateway或ai-app-runtime-gatewaySSE 连接日志。 - 查询是否存在 close event。
- 查询
agent-runtime-gateway是否继续收到 runtime 事件。 - 检查负载均衡 idle timeout。
- 检查客户端重连策略。
17.3 Runtime 任务失败
可能原因:
- 模型调用失败。
- Tool 调用失败。
- Skill 加载失败。
- 文件读取失败。
- 知识检索失败。
- 上下文超预算。
- Runtime 实例异常退出。
排查步骤:
- 查询 Task 终态和错误码。
- 查询 Task Step。
- 查询 runtime event。
- 查询
share-harness日志。 - 检查模型 provider 返回。
- 检查本轮
toolCodes和skillCodes。 - 检查文件和知识权限。
17.4 Skill 未命中或不可用
可能原因:
- 用户未安装 Skill。
- Skill 未发布或已下线。
- Skill 未进入本轮
skillCodes。 - Skill 描述不足,Planner 未选择。
- Skill 依赖 Tool 未授权。
- Skill 依赖知识不可见。
排查步骤:
- 查询用户当前 Skill 授权。
- 查询消息落库的
skillCodes。 - 查询 runtime selected skill 事件。
- 查询 Skill 状态。
- 查询 Skill 绑定知识和 Tool 依赖。
- 检查 Planner 输出。
17.5 知识库无召回
可能原因:
- 用户无知识库权限。
- 前端手选范围为空。
- Skill 绑定范围过窄。
- OpenViking 知识库未完成索引。
- query 不适合当前知识库。
- 检索阈值过高。
- 知识库 Provider 超时。
排查步骤:
- 查询
KnowledgeScopeAdapter返回授权范围。 - 查询本轮
knowledgeAccess。 - 查询用户手选
knowledgeScope。 - 查询 Skill-Knowledge Binding。
- 查询知识检索请求和响应。
- 查询 OpenViking 后台资源状态。
17.6 文件上传或恢复失败
可能原因:
- OSS object key 不存在。
- 文件大小超限。
- 文件类型不支持。
- 文件权限不足。
- runtime restore 失败。
- AGFS mount 未准备好。
排查步骤:
- 查询消息附件记录。
- 查询 OSS 对象是否存在。
- 查询 runtime 文件恢复日志。
- 查询 AGFS file node。
- 查询当前 task 是否有文件读取权限。
17.7 AGFS 挂载异常
可能原因:
- AGFS Server 不可用。
- Metadata Service 不可用。
- Mount 参数错误。
- rootFileId 不存在。
- FUSE Client 异常。
- 权限校验失败。
- Version Tree 首次加载失败。
排查步骤:
- 查询 AGFS Server 健康状态。
- 查询 Metadata Service 日志。
- 查询 mount 请求参数。
- 查询 Space 和 rootFileId。
- 查询 FUSE Client 日志。
- 查询 AGFS 权限拒绝事件。
17.8 多 Agent 子任务卡住
可能原因:
- Task Graph 依赖未满足。
- 上游子任务失败。
- 某个 Agent runtime 不可用。
- 子任务等待文件但文件未生成。
- Reviewer 驳回后未触发重试。
- checkpoint rollback 阻塞。
排查步骤:
- 查询 Task Graph 状态。
- 查询各节点状态。
- 查询节点依赖边。
- 查询子任务 runtime 状态。
- 查询 AGFS 文件产物。
- 查询 handoff event。
- 查询 Reviewer 结果。
18. 演进路线
Roadmap 描述 FlowNex 后续技术演进方向。
18.1 半年技术演进路线
未来半年建议按以下里程碑推进:
| 里程碑 | 时间 | 阶段主题 | 核心目标 |
|---|---|---|---|
| M1 | 2026-08 | 知识库 P0 接入 | OpenViking 知识库成为组织知识检索底座 |
| M2 | 2026-09 | 知识治理与 Skill 绑定 | 知识可管、可绑、可观测 |
| M3 | 2026-10 | AGFS P0 | 运行时文件进入自建 AGFS |
| M4 | 2026-11 | AGFS 版本、快照与多 Agent 协作 P0 | AGFS 支撑共享工作区和任务级回滚 |
| M5 | 2026-12 | AGFS 与知识、Skill、Memory 闭环 | 运行产物和任务经验进入沉淀闭环 |
| M6 | 2027-01 | 能力中台 Beta | 形成面向业务复用的 AI-Agent 能力中台 Beta |
| M7 | 2027-02 | 能力管理融合与业务线接入规模化 | 支持业务线 AI 应用和原子化 AI 能力统一接入、授权、调用、观测和运营 |
18.2 知识库演进
知识库演进方向:
- 完成 OpenViking 组织知识库 P0 接入。
- 完善本地知识资产、映射和 ACL。
- 支持用户手选知识库。
- 支持 Skill 绑定知识库。
- 支持知识命中引用追踪。
- 支持知识命中质量分析。
- 支持从 AGFS 高价值文件生成知识草稿。
长期目标:
- 知识可治理。
- 知识可绑定。
- 知识可观测。
- 知识可沉淀。
- 知识可评估。
18.3 AGFS 演进
AGFS 演进方向:
- AGFS Metadata Service P0。
- AGFS Server P0。
share-harnessworkspace 接入 AGFS。- HTTP File API。
- MCP File Tools。
- FUSE Mount。
- Version Tree。
- close-to-open 一致性。
- Shadow Dir。
- 文件版本。
- checkpoint 和 rollback。
- 多 Agent 共享 project space。
- 文件权限。
- 文件血缘。
- 知识候选沉淀。
长期目标:
AGFS 成为 Agent 运行时文件世界的基础设施层。
18.4 多 Agent 演进
多 Agent 演进方向:
- 角色模型。
- Task Graph。
- 子任务分发。
- Agent Handoff。
- 共享知识和共享文件。
- Reviewer 审查。
- Synthesizer 汇总。
- 子任务 checkpoint。
- 失败恢复。
- 多 Agent 运营指标。
第一期应采用受控多 Agent,不建议直接做完全自治的 Agent 群聊。
长期目标:
复杂业务任务可被拆解、并行执行、审查、合并和回滚。
18.5 Skill 与 Memory 演进
Skill 与 Memory 演进方向:
- Skill 版本化。
- Skill 评测集。
- Skill 灰度发布。
- Skill 与知识绑定效果分析。
- 从 badcase 生成 Skill 改进候选。
- 从用户反馈生成 runtime reminder。
- 从任务轨迹沉淀 case、faq、playbook。
- Memory 保存长期偏好和稳定经验。
关键原则:
- 经验可以自动提炼。
- 公共能力修改必须审核。
- Skill 发布必须可评测。
- 错误经验必须可回滚。
18.6 能力中台 Beta 目标
能力中台 Beta 需要达到:
- 业务管理员可以配置 Agent 能力包。
- 能力包可以组合 Skill、Tool、知识库和 AGFS 空间。
- 用户可以通过 Web 或飞书使用 Agent。
- 任务过程可追踪。
- 知识命中可解释。
- 文件产物可管理。
- 多 Agent 可协作。
- Skill 效果可运营。
- badcase 可沉淀。
- 核心配置可灰度和回滚。
18.7 能力管理融合与业务线接入规模化
接入方案上线后,FlowNex 的后续演进需要新增一条“能力管理融合”主线。
阶段目标:
| 阶段 | 目标 | 关键产物 |
|---|---|---|
| P0 | 能力目录可用 | Capability Registry、能力元数据、Schema、负责人、状态 |
| P1 | Provider Adapter 可复用 | HTTP / RPC Adapter 模板、错误码映射、鉴权引用、超时重试 |
| P2 | 租户级能力开通 | Tenant Capability Config、部门 / 角色授权、能力启停 |
| P3 | Runtime 统一调用 | Capability Gateway、Tool 映射、Task Step、Trace 回传 |
| P4 | 运营与质量闭环 | 调用统计、成功率、成本、自动回归、灰度和回滚 |
这条主线需要与现有模块打通:
- 与 Skill System 打通:原子能力可以封装为 Tool,并进一步组合成 Skill。
- 与 Knowledge System 打通:Capability 可绑定知识上下文,但必须服从用户和租户 ACL。
- 与 AGFS 打通:能力输入输出可以引用 AGFS 文件,避免大文件在服务间反复传输。
- 与 Multi-Agent 打通:不同 Agent 子任务可调用不同业务线能力,并在 Task Graph 中记录调用关系。
- 与 Observability 打通:按业务线、能力、Provider、租户、Agent、Skill 统计调用效果。
- 与 Security 打通:能力级授权、凭证托管、数据脱敏、审计和 HITL 成为默认要求。
规模化接入的验收标准:
- 业务线可以按模板提交能力接入申请。
- 平台可以在管理台完成能力注册、授权、灰度和下线。
- Agent 可以通过统一 Tool 调用业务线能力。
- 用户侧不感知能力来自哪个业务线。
- 管理员可以查询每个能力的调用量、成功率、耗时、成本和错误分布。
- 高风险能力支持二次确认、审计和回滚。
- Provider 或 Adapter 变更后可通过自动回归测试验证。
最终目标:
FlowNex 从单点 Agent 应用演进为行云 AI-Agent 自研能力中台,支撑企业规模化生产、运行、治理和演进 Agent 能力。