13. 可观测性
Observability 描述 FlowNex 如何观测一次 Agent 任务从入口、编排、运行时、工具、知识、文件到最终结果的完整链路。
企业级 Agent 平台必须具备可解释和可排障能力。一次 Agent 回答不应只是“模型说了什么”,还应能回答“系统为什么这样做”。
13.1 日志规范
日志应覆盖所有核心服务:
ai-claw-gateway。ai-app-runtime-gateway。ai-app-service。control-center。agent-domain-service。user-domain-service。agent-runtime-gateway。share-harness。- AGFS Server。
- AGFS Metadata Service。
日志字段建议统一:
traceId。tenantCode。userId。conversationId。taskId。messageId。runtimeInstanceId。eventType。errorCode。durationMs。capabilityCode。providerCode。adapterCode。
日志级别建议:
INFO:关键业务事件。WARN:可降级异常、重试、权限裁剪、超时。ERROR:任务失败、状态不一致、数据持久化失败。DEBUG:开发环境详细上下文。
13.2 Trace 链路
Trace 用于串联跨服务请求。
核心 trace 头:
X-Trace-Id。X-User-Id。- 租户标识。
- Dubbo attachment 中的 trace 和 user 上下文。
一轮任务至少应串联:
ai-claw-gateway main request / ai-app-runtime-gateway application request
  -> control-center main interaction / ai-app-service application interaction
  -> control-center create task or invoke capability
  -> agent-domain-service persistence
  -> agent-runtime-gateway infer
  -> share-harness run
  -> runtime callback
  -> SSE push
Trace 不只用于技术排障,也用于审计和任务回放。
13.3 Runtime 事件
Runtime 事件是观察 Agent 执行过程的核心。
建议事件类型:
task.started。planner.started。planner.completed。skill.recalled。skill.loaded。tool.started。tool.completed。knowledge.search.started。knowledge.search.completed。file.created。file.updated。checkpoint.created。checkpoint.rollback。task.completed。task.failed。
Runtime 事件有两类消费者:
- SSE 展示。
- 后台持久化和指标统计。
13.4 任务执行指标
任务执行指标用于观察 Agent 系统整体健康度。
建议指标:
- 任务总数。
- 成功任务数。
- 失败任务数。
- 取消任务数。
- 平均任务耗时。
- P95 / P99 任务耗时。
- 平均 Task Step 数。
- 平均模型调用次数。
- 平均工具调用次数。
- 平均 token 消耗。
按维度聚合:
- 租户。
- 用户。
- Agent。
- Skill。
- 渠道。
- 模型。
- 任务类型。
13.5 知识命中指标
知识命中指标用于判断知识库是否有效。
建议指标:
- 知识检索次数。
- 知识命中次数。
- 无命中次数。
- 检索超时次数。
- 平均检索耗时。
- 命中文档数。
- 最终引用片段数。
- 因权限裁剪的知识数。
- 因 Skill
FORBIDDEN裁剪的知识数。 REQUIRED知识缺失次数。
这些指标可以帮助管理员发现:
- 哪些知识库没人用。
- 哪些知识库经常无召回。
- 哪些 Skill 绑定知识过窄。
- 哪些知识权限配置不合理。
- 哪些知识需要更新或归档。
13.6 Skill 使用指标
Skill 使用指标用于运营企业 Agent 能力。
建议指标:
- Skill 曝光次数。
- Skill 命中次数。
- Skill 实际使用次数。
- Skill 任务成功率。
- Skill 任务失败率。
- 平均执行耗时。
- 平均 token 消耗。
- 关联知识命中率。
- 用户点赞率。
- 用户点踩率。
这些指标可以指导:
- 哪些 Skill 值得推广。
- 哪些 Skill 需要下线。
- 哪些 Skill 需要补充知识。
- 哪些 Skill 需要优化提示词或工具链。
13.7 AGFS 文件指标
AGFS 指标用于观察 Agent 文件系统健康度。
建议指标:
- 文件读次数。
- 文件写次数。
- 目录查询次数。
- 文件版本创建次数。
- checkpoint 创建次数。
- rollback 次数。
- Shadow Dir 命中次数。
- Version Tree 命中率。
- Metadata Service QPS。
- Object Storage 上传下载耗时。
- FUSE mount 成功率。
- 多 Agent 文件同步延迟。
AGFS 指标直接影响 Agent 任务体验。目录查询慢、文件同步延迟高、checkpoint 失败都会影响多 Agent 协作质量。
13.8 多 Agent 协作指标
多 Agent 指标用于观察复杂任务协作质量。
建议指标:
- Task Graph 创建数。
- 平均子任务数。
- 子任务成功率。
- 子任务重试次数。
- Handoff 次数。
- Reviewer 驳回次数。
- Synthesizer 合并失败次数。
- checkpoint rollback 次数。
- 多 Agent 总耗时。
- 多 Agent 相比单 Agent 的成功率提升。
这些指标用于判断多 Agent 是否真的提升了复杂任务完成质量,而不是增加系统复杂度。
13.8.1 接入能力的调用观测与质量评估
业务线 AI 应用和原子化 AI 能力接入后,FlowNex 需要新增按能力维度的观测体系。
能力调用 Trace 至少应覆盖:
capabilityCode。capabilityVersion。providerCode。adapterCode。tenantCode。agentCode。skillCode。toolCode。- 输入 Schema 版本。
- 输出 Schema 版本。
- 调用状态。
- 错误码和错误映射。
- 耗时。
- 重试次数。
- 降级策略。
- 成本或计量信息。
能力运营指标建议按以下维度聚合:
| 维度 | 指标 |
|---|---|
| 业务线 | 调用量、成功率、P95 耗时、错误分布、成本 |
| 能力 | 调用量、成功率、平均耗时、Schema 失败率、降级次数 |
| Provider | 可用率、超时率、重试次数、SLA 达成率 |
| 租户 | 开通能力数、使用活跃度、调用成本、失败 Top 能力 |
| Agent / Skill | 调用了哪些原子能力、对任务成功率的贡献、失败原因 |
对于高价值或高风险能力,还应接入自动回归测试:
- 维护标准输入输出样例。
- 在 Provider 或 Adapter 变更后自动回放。
- 对关键字段准确率、格式稳定性、耗时和错误率做评估。
- 将回归结果作为能力发布、灰度和回滚依据。
这样可以避免业务线能力“接进来了但不可运营”,也能帮助平台判断某个 Agent 失败到底来自模型、Skill、知识、Tool 还是外部 Capability。
13.8.2 Coze Loop 观测落地形态
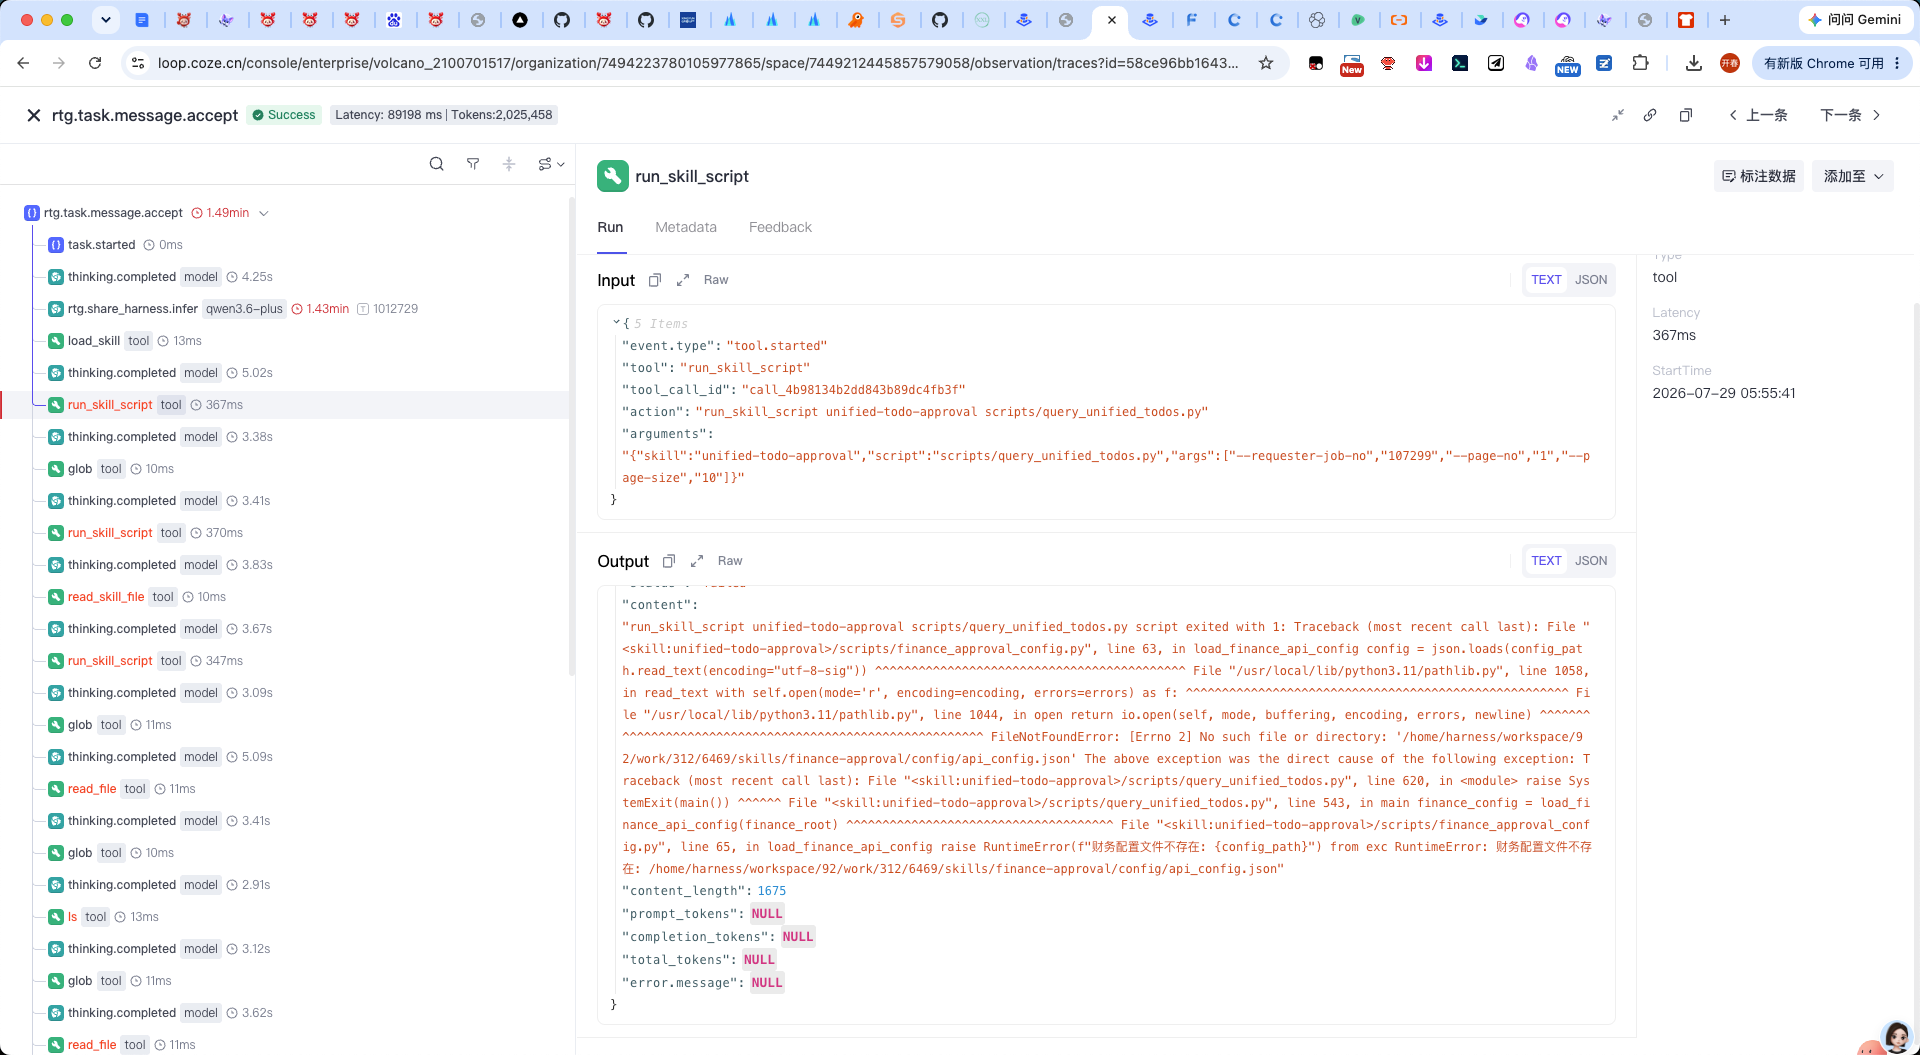
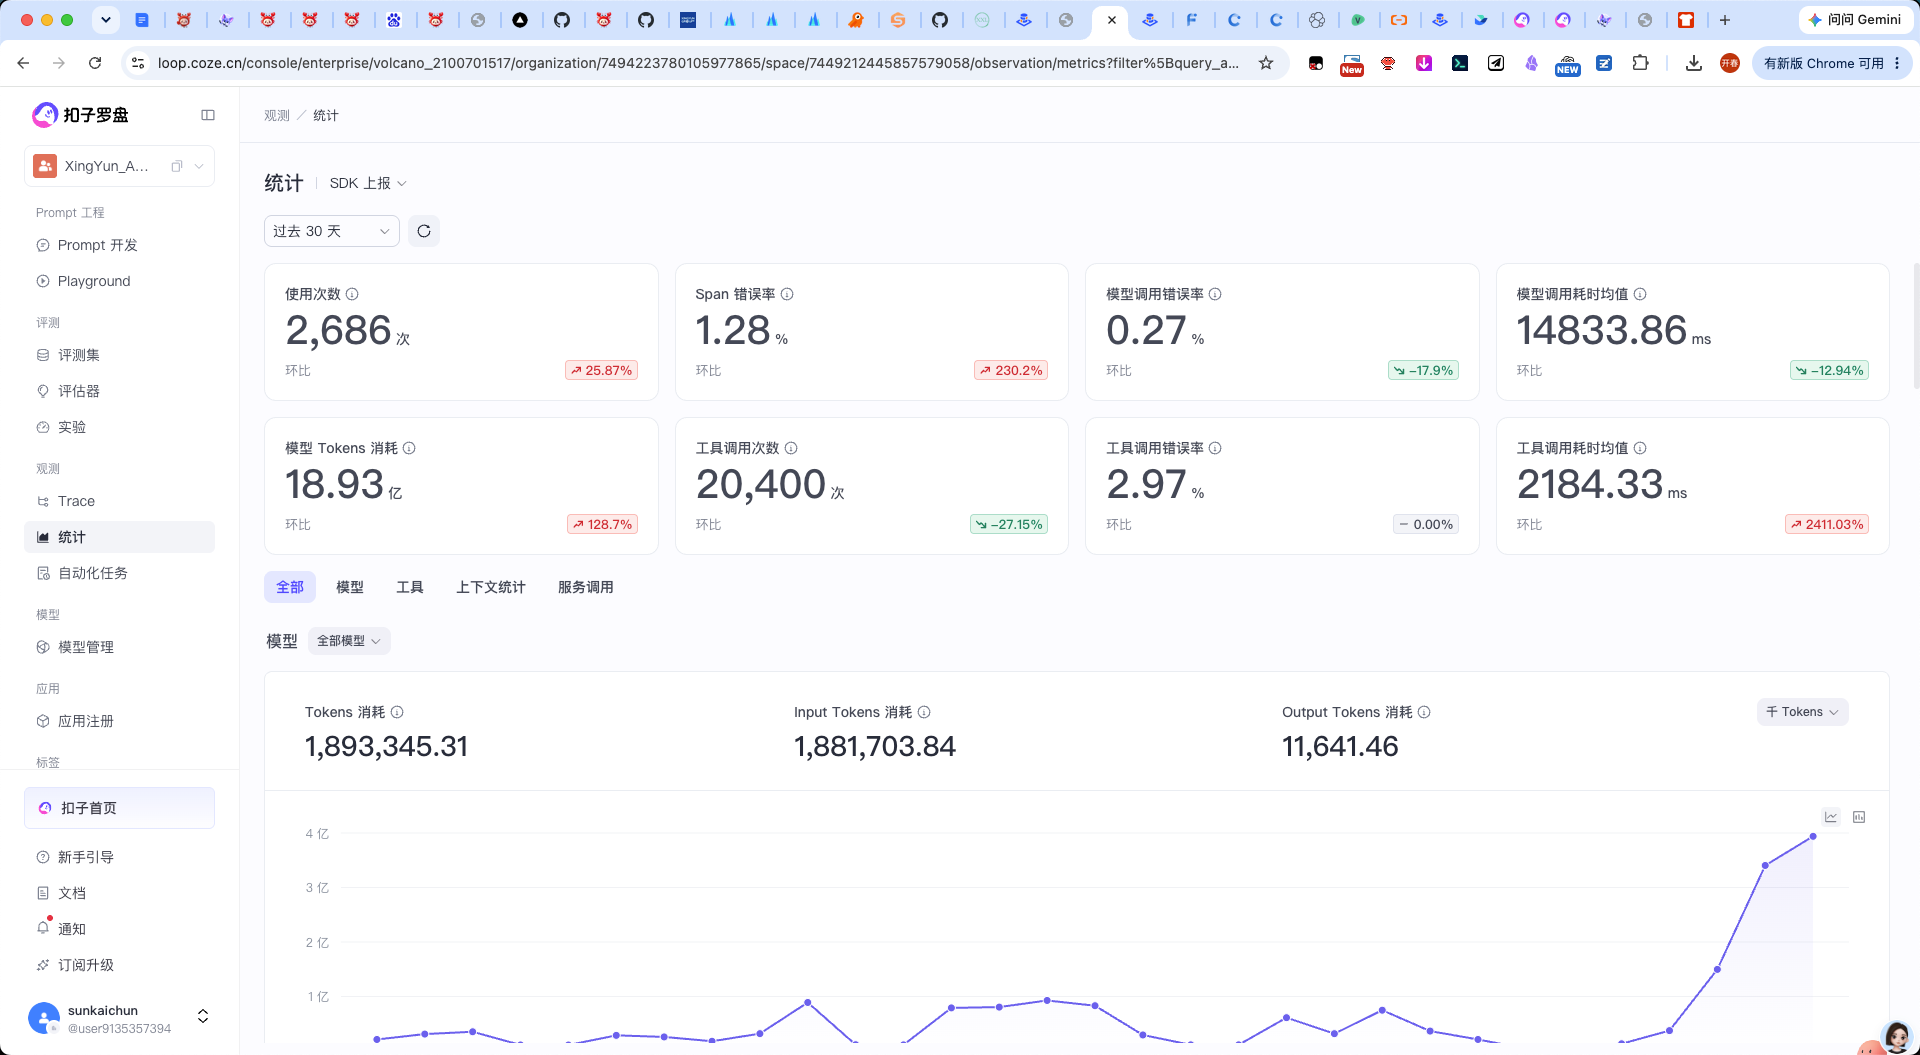
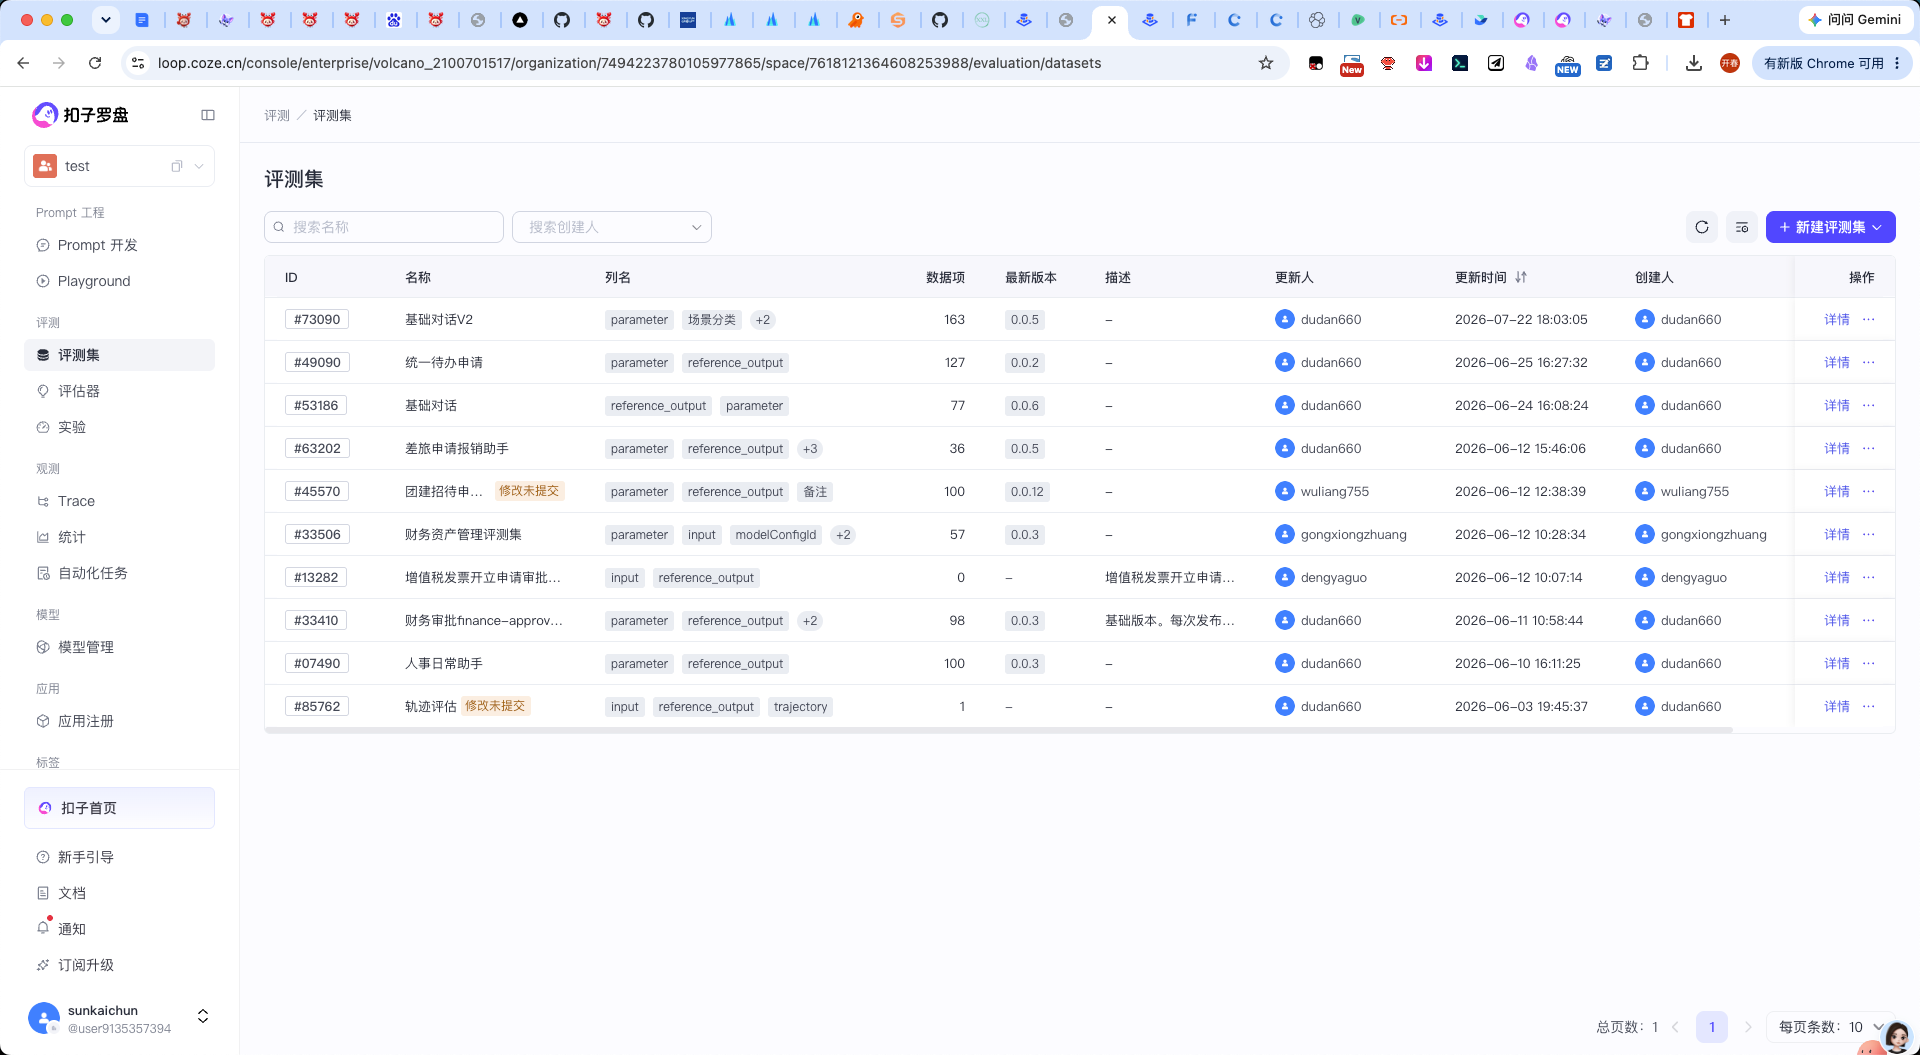
FlowNex 在线运行观测可以结合 Coze Loop 产品落地,重点覆盖三类能力:
- 线上运行日志查询:通过
traceId按入口串联ai-claw-gateway或ai-app-runtime-gateway,并继续关联ai-app-service、control-center、agent-runtime-gateway、share-harness和 Provider 调用日志。 - 监控统计:按应用、租户、能力、Provider、模型、Agent、Skill 统计调用量、成功率、耗时、错误分布和成本。
- 自动回归测试:沉淀高价值任务和能力调用样例,在 Prompt、Skill、Provider Adapter 或模型配置变更后自动回放,辅助发布验收和回滚决策。
Coze Loop 观测闭环
将生产 Trace、指标看板和评测数据集组织成一条持续改进链路:线上问题可定位、能力质量可量化、发布变更可回归。
13.9 告警与排障
建议配置告警:
- Runtime 实例不可用。
- SSE 连接异常升高。
- 任务失败率异常。
- 模型调用超时。
- Tool 调用失败率异常。
- 知识检索超时。
- AGFS Metadata Service 延迟异常。
- AGFS checkpoint 失败。
- RocketMQ 消费堆积。
- MySQL 慢查询。
排障入口应支持按以下字段检索:
traceId。taskId。conversationId。messageId。userId。skillCode。knowledgeAssetId。agfsFileId。